요구사항은 "2차 인증 수단 추가" 하나였다. 그런데 작업이 끝나니 기존 인증 흐름의 결함 4건이 함께 고쳐져 있었다. 기능을 붙이는 일은 기존 코드의 암묵적 가정을 검증하는 일이기도 하다는 기록. (1부 — 외부 FIDO 2차 인증 연동, 매뉴얼에 없는 것들)
서비스·클래스 이름은 일반화했고, 코드는 단순화한 예시다. 아래 결함은 모두 발견 즉시 수정되어 현재는 존재하지 않는다.
왜 연동 작업이 결함을 드러내는가
새 2차 인증 분기를 끼워 넣으려면 기존 분기를 전부 읽어야 한다. 그 과정에서 "지금까지 우연히 동작하던 것"이 보인다. 아래 4건은 전부 FIDO 분기를 추가할 자리를 찾다가 발견했다.
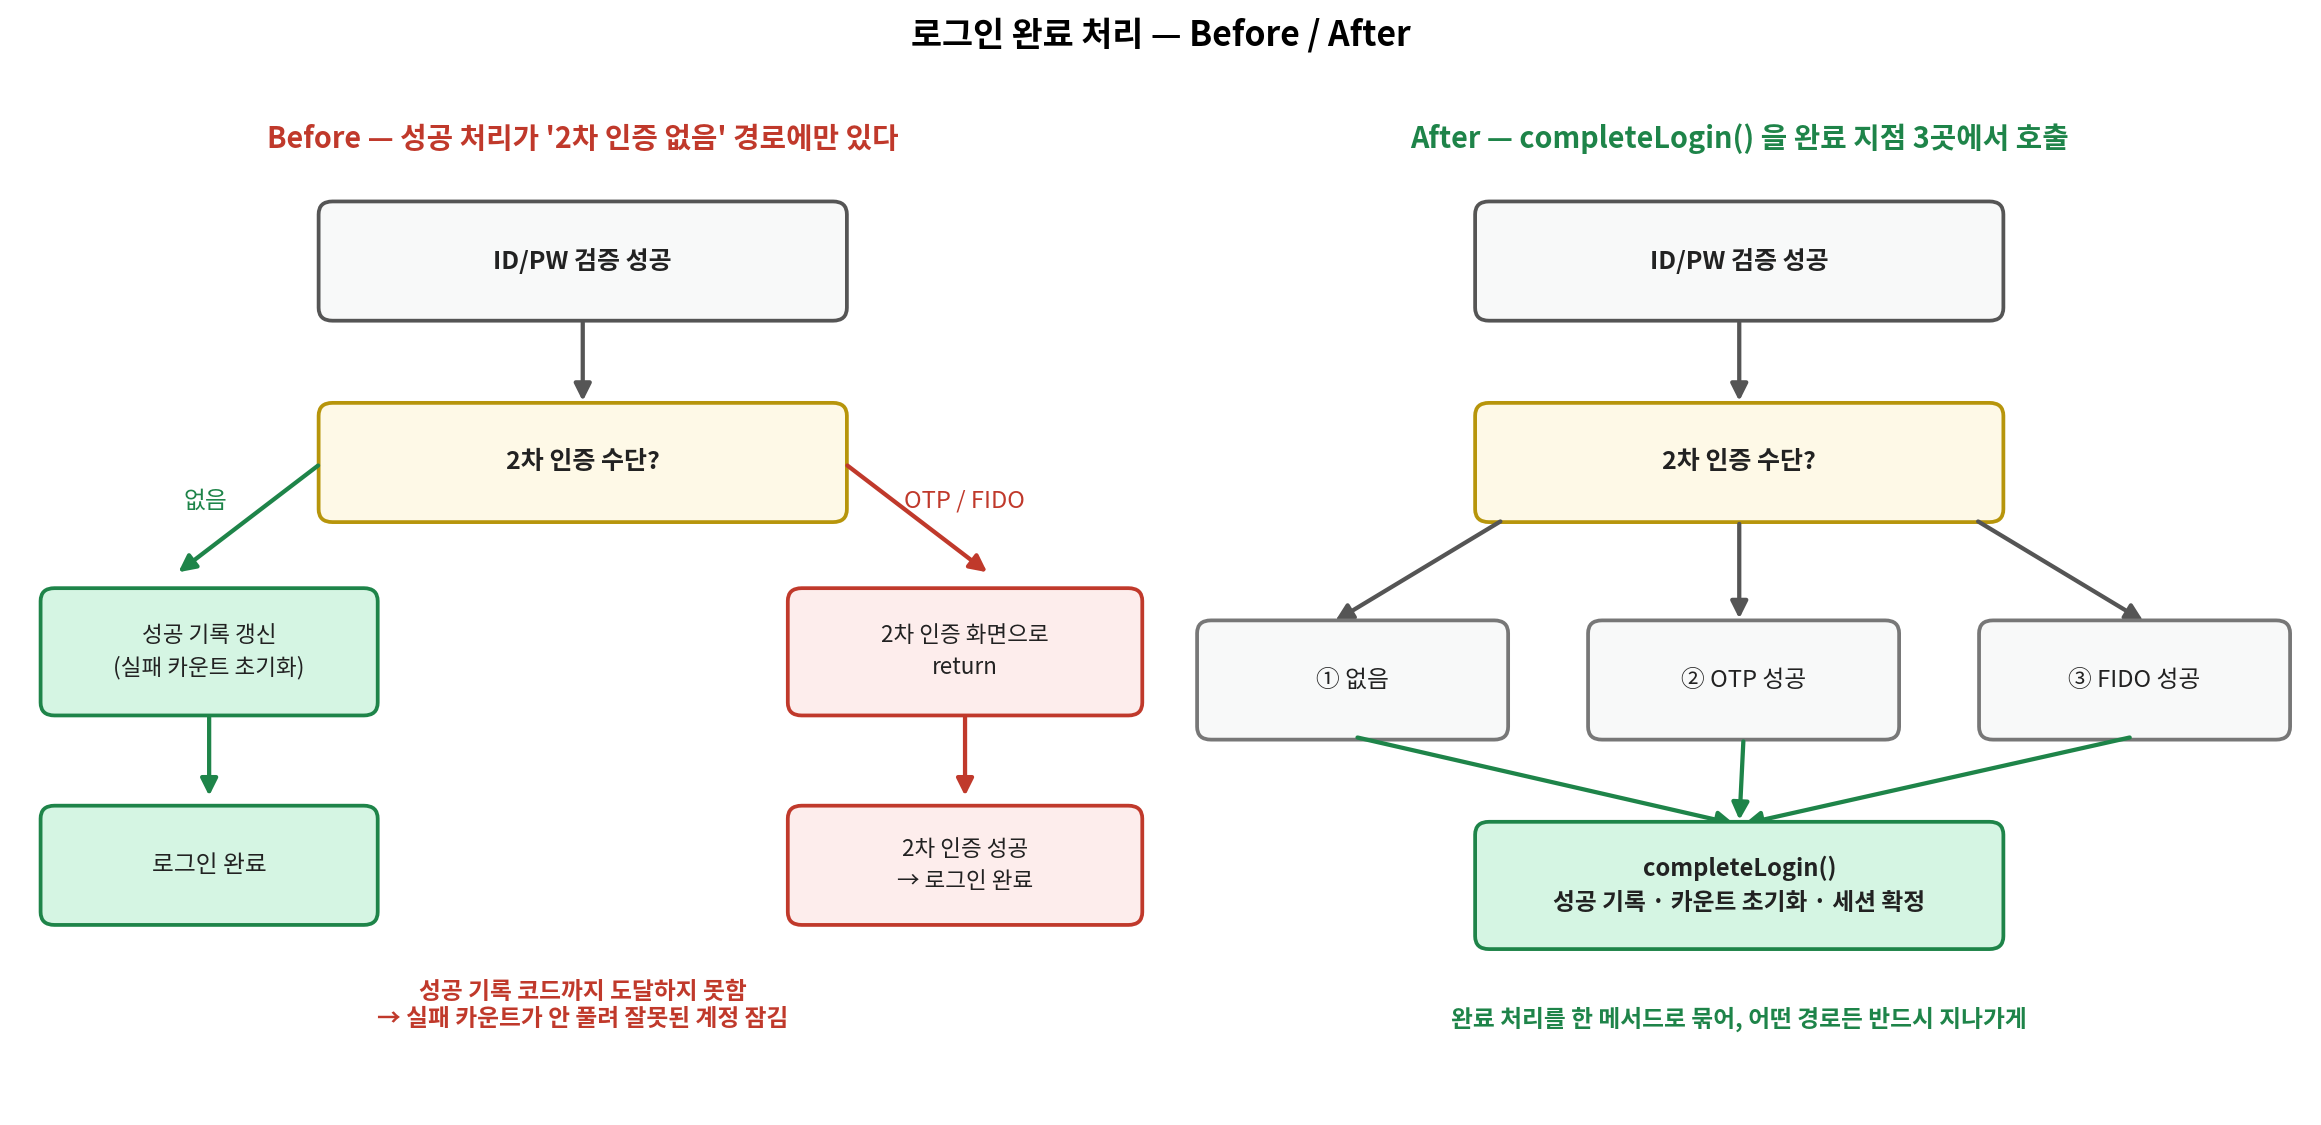
구멍 ① 2차 인증 계정만 로그인 성공 기록이 안 남는다
발견 — 성공 기록 메서드(setLoginSuccess)가 어디서 호출되는지 따라가 보니, 2차 인증 분기(return "otp")보다 뒤에 있었다. 2차 인증 대상 계정은 이 줄에 영원히 도달하지 못한다.
영향 — 마지막 로그인 일시가 갱신되지 않고, 로그인 실패 카운트가 초기화되지 않는다. 비밀번호를 4회 틀린 뒤 성공해도 카운트가 4로 남아, 다음 1회 실패에 계정이 잠긴다. "가끔 이유 없이 계정이 잠긴다"는 유형의 문의가 생기는 구조다.
수정 — 완료 처리를 completeLogin() 하나로 묶고, 로그인이 끝나는 세 지점(2차 인증 없음 / OTP 성공 / FIDO 성공)에서 모두 호출했다.
성공 처리 같은 공통 로직은 "분기마다 복사"가 아니라 "모든 경로가 지나는 한 지점"에 두어야, 분기가 늘어날 때(이번처럼) 누락되지 않는다.
구멍 ② 권한 관리가 '메뉴 숨김'에만 의존한다
발견 — 관리자 관리 기능은 상위 권한에게만 메뉴가 보인다. 그런데 컨트롤러와 인터셉터 어디에도 세션 권한을 검사하는 코드가 없었다. 로그인 인터셉터는 "로그인했는가"만 본다.
영향 — 로그인한 하위 권한 계정이 URL을 직접 호출하면 계정 생성, 타 계정의 2차 인증 수단 변경 같은 관리 기능이 실행됐다. 전형적인 권한 상승이다. 메뉴 숨김은 UX이지 보안이 아니다.
수정 — 인터셉터 하나를 관리 경로(/management/manager/**)에 등록해 서버에서 차단했다. AJAX 요청은 403 + 안내 문구, 화면 요청은 권한별 첫 화면으로 리다이렉트, 시도는 경고 로그.
판단 — 검사를 어디에 둘 것인가
위치
기각/채택 이유
Service
같은 서비스가 전 권한이 쓰는 프로필 화면도 지원 → 넣으면 정상 기능이 막힘. 세션을 모르는 계층이기도 함
Controller
메서드 9개에 각각 삽입 → 신규 메서드 추가 시 누락 위험
Interceptor (채택)
URL 패턴 단위로 일괄 적용, 이후 추가되는 기능까지 자동 보호
구멍 ③ 2차 인증이 '조용히' 생략될 수 있다
발견 — 2차 인증 수단 판정이 equals("OTP") 같은 대소문자·공백에 민감한 비교였다. 그런데 DB에는 NONE/none/공백 등 형식이 섞여 있었다.
영향 — " OTP"처럼 공백 하나만 섞여 저장돼도 어떤 분기에도 걸리지 않아 2차 인증이 통째로 생략된다. 오류가 나는 게 아니라 조용히 통과하는 것이 더 위험하다.
수정 — 비교 지점에서 trim().toUpperCase() 후 판정하도록 정규화했다.
판단 두 가지 — ① DB 일괄 정리 대신 로직 흡수: 운영 DB UPDATE는 이 값을 읽는 다른 시스템까지 영향 범위를 확인해야 해서, 비교 지점 한 곳에서 흡수하는 쪽이 안전했다. ② 알 수 없는 값일 때 "차단"으로 바꾸지 않고 현행(생략) 유지 + 후속 과제로 기록: 지금 차단으로 바꾸면 이상 값이 든 계정이 즉시 전부 잠기는 사고가 된다. 데이터 정리가 끝난 뒤에 전환해야 할 순서의 문제였다.
구멍 ④ 화면에 보이는 값과 저장되는 값이 다르다
발견 — 특정 권한은 2차 인증 미사용을 골라도 서버가 OTP로 덮어쓰는데, 화면에는 미사용 선택지가 그대로 노출됐다. 여기에 사내 공통 드롭다운 스크립트의 refresh 함수가 전역으로 덮어써져 페이지의 마지막 select만 갱신되는 버그까지 겹쳐, 고친 화면조차 실제 값과 다르게 보였다.
영향 — 관리자가 본 값과 다른 값이 저장된다. 등록한 적 없는 OTP를 요구받아 로그인이 불가능해질 수 있는 경로다.
수정 — 해당 권한에서는 미사용 선택지를 숨기고, 상세 화면은 자동 보정 없이 DB에 저장된 실제 값을 그대로 표시했다. 화면의 원칙은 "보기 좋게"가 아니라 "저장될 값과 같게"다.
판단 — 공통 스크립트를 고치면 전 화면이 회귀 범위가 된다. 원인만 기록해 공유하고, 이 화면에서는 해당 select만 직접 갱신해 우회했다.
실패 경험: 증상만 보고 코드부터 의심했다
배포 후 "모든 계정에 FIDO 인증 창이 뜬다"는 증상을 듣고 바로 코드를 추적했다. 직전 커밋에서 enum 순서를 바꾼 것이 화면 기본 선택값을 바꾼 걸 찾아냈는데 — 정작 증상의 원인은 그게 아니었다. 확인하던 DB가 다른 서비스의 DB였다.
얻은 것도 있었다. 틀린 추적 중에 찾은 enum 순서 문제는 "상세 화면을 열고 저장만 해도 인증 수단이 바뀌는" 실제 잠재 버그여서 되돌려 수정했다. 그래도 교훈은 분명하다. 장애 분석의 첫 질문은 코드가 아니라 "지금 보고 있는 환경·데이터가 맞는가"다. SELECT 한 번이면 바로 좁혀질 일이었다.
고치지 않은 것들, 그리고 기준
발견한 것을 전부 고치지는 않았다. 공통 드롭다운 스크립트(전 화면 회귀 위험), DB 형식 일괄 정리(타 시스템 영향 범위 미확인)는 범위에서 제외하고 원인과 함께 기록으로 남겼다. 기준은 세 가지였다.
영향 범위 — 이 수정이 닿는 화면·시스템을 내가 전부 알고 있는가
회귀 위험 — 잘못됐을 때 알아챌 수 있고, 되돌릴 수 있는가
소유권 — 공통 모듈·타 시스템 데이터처럼 내 결정만으로 바꿀 수 없는 것인가 요구사항 밖에서 발견한 문제는 "다 고치는 것"이 아니라, 고칠 것과 기록할 것을 나누는 것까지가 일이었다.
성과와 회고
외부 2차 인증 연동 1건 + 기존 인증 흐름 결함 4건 수정 (잘못된 계정 잠김, 권한 상승 경로, 2차 인증 생략 가능성, 화면-저장값 불일치)
로그인 컨트롤러의 연동 분기 약 35줄 → 9줄, 결과 코드 enum 일원화 레거시에 기능을 붙이는 일의 절반은 고고학이었다. 지층(기존 분기)을 파다 보면 설계 당시의 가정이 나오고, 그 가정 중 일부는 이미 깨져 있다. 이번에 배운 것은 결함을 찾는 눈보다, 찾은 것을 어디까지 고치고 어디서 멈출지 정하는 기준이 한 사람의 몫이라는 점이다.
레거시 Spring MVC 관리자 콘솔에 외부 FIDO 2차 인증을 연동했다. 매뉴얼은 호출할 API 3개를 알려준다. 하지만 토큰을 언제 갱신할지, 브라우저가 보낸 값 중 무엇을 믿을지, 설정을 고쳤는데 왜 반영이 안 되는지는 알려주지 않는다. 그 "매뉴얼에 없는 것들"을 정리했다.
서비스·클래스·설정 이름은 일반화했고, 코드는 단순화한 예시다. 외부 인증 서비스는 가칭 "FidoAuth"로 부른다.
항목
내용
과제
기존 OTP와 병행할 FIDO 2차 인증 추가, 관리자별 수단 전환
기간 / 역할
2026.09~10 (약 1주) / 설계·구현·테스트 단독
기술
Java 11, Spring MVC(non-Boot), MyBatis, JSP
1. 연동 구조
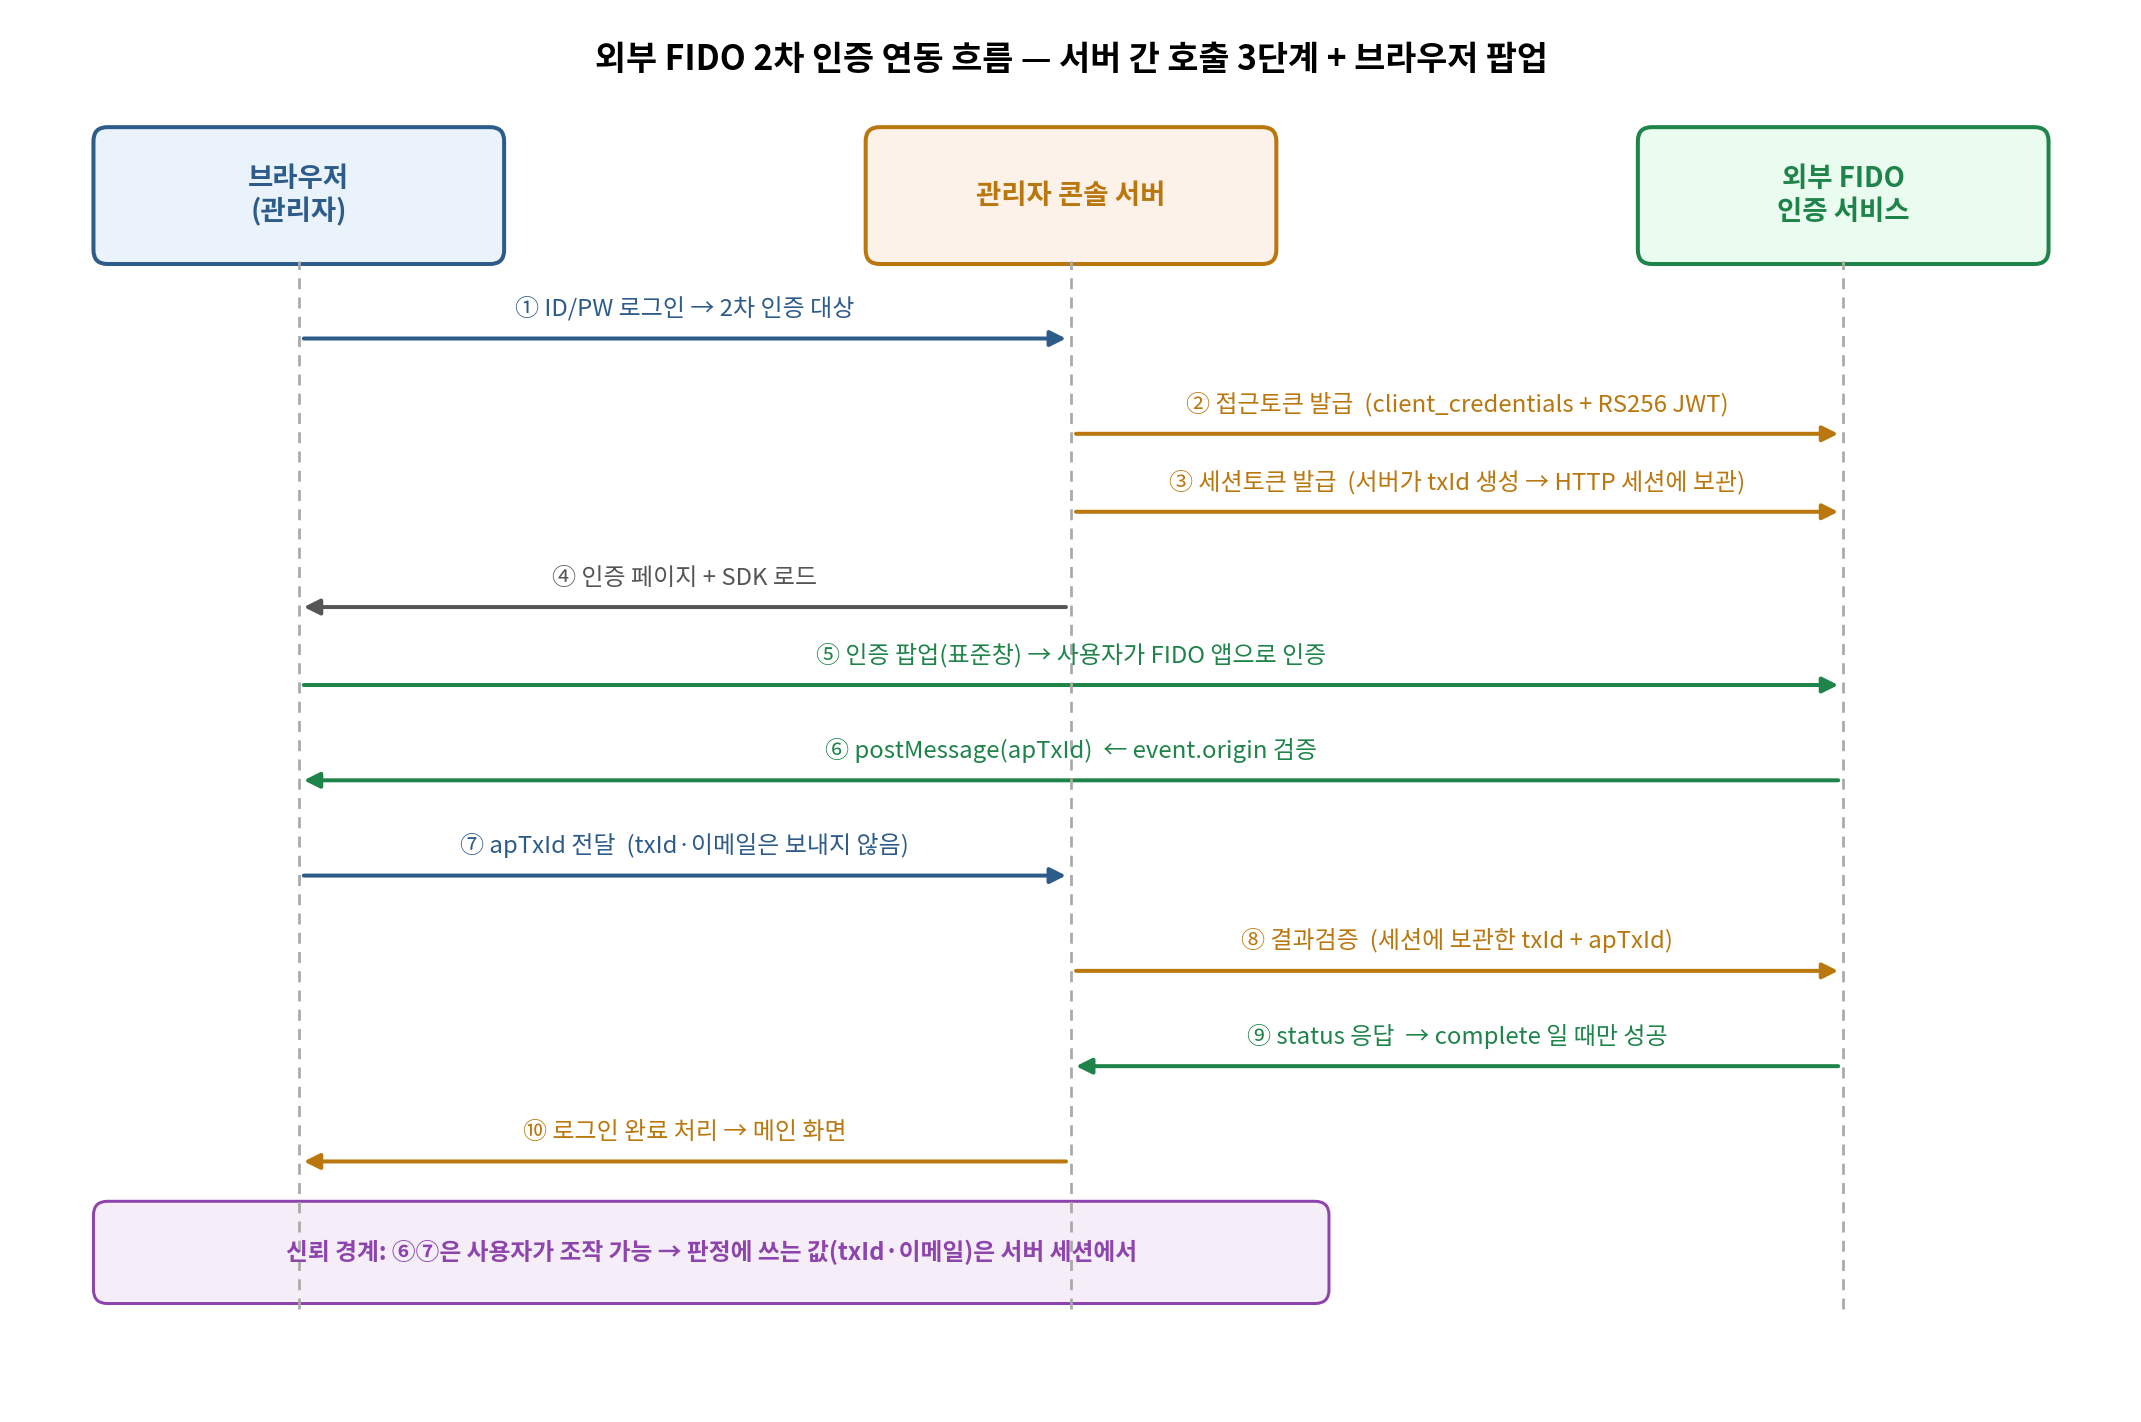
서버 간 호출 3단계(접근토큰 → 세션토큰 → 결과검증)와 브라우저 팝업 + postMessage가 섞인 구조다. 서버와 브라우저가 번갈아 등장하기 때문에, 설계의 첫 질문은 "어느 쪽 값을 믿을 것인가"가 된다.
2. 원칙 ① 브라우저가 보낸 값은 믿지 않는다
결과검증에 필요한 거래번호(txId)와 사용자 식별값은 브라우저가 보내주는 값을 쓰면 편하지만, 브라우저 값은 사용자가 얼마든지 조작할 수 있다. 다른 계정의 인증 결과로 바꿔치기할 수 있다는 뜻이다. 그래서 txId는 서버가 생성해 HTTP 세션에 보관하고, 결과검증 때도 세션 값을 쓴다. 브라우저에서는 FidoAuth가 발급한 apTxId 하나만 받는다.
팝업이 결과를 돌려주는 postMessage는 아무 사이트나 보낼 수 있는 API인데, 매뉴얼 예제에는 발신자 검증이 없었다. event.origin 확인 한 줄을 추가했다.
window.addEventListener("message", function (event) {
    if (event.origin !== FIDO_AUTH_ORIGIN) return;   // 매뉴얼 예제에 없던 줄
    handleAuthResult(event.data);
});
메시지 없이 팝업 X 버튼을 눌러 닫는 경우는 window.open 핸들의 closed를 폴링해 감지하고, 안내 후 로그인 화면으로 돌려보냈다.
3. 원칙 ② 토큰은 발급보다 수명 관리가 일이다
접근토큰은 OAuth2 client_credentials인데, 클라이언트 인증을 RS256 서명 JWT(clientAssertion)로 한다. 발급은 매뉴얼대로 하면 되고, 문제는 "매 요청마다 발급할 것인가"다. 관리자 콘솔은 단일 인스턴스라 Redis는 과하고, 매번 발급은 낭비라서 메모리 캐시를 택했다. 대신 두 가지를 보탰다 — 만료 60초 전 선제 갱신(요청 도중 만료 방지), 만료 응답 시 캐시 폐기 후 1회만 재시도(제한 없으면 외부 장애 시 무한 루프).
String accessToken() {
    CachedToken t = cached;
    if (t == null || t.expiresWithin(Duration.ofSeconds(60))) {
        cached = t = issueNewToken();   // RS256 clientAssertion으로 발급
    }
    return t.value();
}
4. 원칙 ③ 성공 판정은 코드가 아니라 상태로
응답에는 결과 코드와 상태(status)가 함께 온다. 정상 코드이면서 상태는 pending(인증 중)·cancelled·expired인 경우가 있어서, 성공은 오직 status == complete일 때뿐이다.
if (!"complete".equals(response.getStatus())) {
    throw new SecondFactorAuthException(EnumFidoAuthResult.of(response.getResultCode()));
}
결과 코드 41개는 enum 하나로 매핑해 안내 메시지와 로그를 한 곳에서 관리했다. 외부 호출이니 타임아웃(connect 3s / read 10s)을 걸고(기본값은 무한 대기라 외부 장애 = 로그인 전체 멈춤), 토큰이 담긴 응답 본문 로그는 제거했다.
5. WAR 하나로 환경별 설정 분리
서버마다 FidoAuth 도메인·서비스 ID·개인키가 다르다. 환경별 빌드 대신, WAR 내부 기본 설정 위에 JVM 옵션으로 지정한 외부 파일이 같은 키를 덮어쓰는 구조를 썼다. 배포 산출물은 하나, 서버마다 외부 파일 값만 다르다.
WAR 내부   config.properties           : fidoauth.enabled=false (기본: 꺼짐)
서버 외부  /etc/app/config.properties  : fidoauth.enabled=true, domain=..., private-key-path=...
플래그는 enabled=false여도 기존 사용자의 설정 데이터는 보존하고 신규 전환만 막게 했다. 스위치 조작이 데이터 변경을 일으키면 안 된다.
6. 실패 경험 2가지
① "설정을 고쳤는데 반영이 안 된다" — 외부 설정의 도메인을 바꿨는데 팝업이 계속 이전 도메인으로 열렸다. 원인은 파일이 아니라 읽는 시점: Spring 설정값은 기동(deploy) 때 한 번만 읽힌다. 이후 기동 시 적용값을 로그로 찍게 하고([FidoAuth] enabled. domain=...), 배포 절차를 "외부 설정 선적용 → deploy → 기동 로그 확인"으로 문서화했다. 확인할 것은 파일이 아니라 애플리케이션이 읽은 값이다.
② "연결 확인 = ping"이라는 착각 — 연동은 HTTPS(TCP 443)라 ICMP인 ping은 성공도 실패도 의미가 약하다. curl로 보내면 단계가 보인다.
상품 수정 API를 테스트하다가 이상한 현상을 만났다. 카테고리를 다른 값으로 바꾸면 정상 동작하는데, 기존과 같은 카테고리로 수정 요청을 보내면 500이 떨어졌다.
ERROR: duplicate key value violates unique constraint "uk_products_categories"
상품과 카테고리는 중간 테이블로 연결되어 있고, 같은 쌍이 두 번 연결되는 걸 막기 위해 UNIQUE 제약을 걸어둔 상태였다.
CREATE TABLE products_categories
(
    id          BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    product_id  BIGINT NOT NULL,
    category_id BIGINT NOT NULL,
    UNIQUE (product_id, category_id)
);
아무것도 바꾸지 않는 요청인데 왜 "중복"이 생길까?
재현
문제의 코드는 카테고리 교체 로직이었다. "기존 연결을 전부 지우고, 새 연결을 추가한다"는 단순한 발상이었다.
// Product.java
public void changeCategory(Category newCategory) {
    productCategories.clear();    // 기존 (10, 5) 제거 → DELETE 예정
    addCategory(newCategory);     // 새 (10, 5) 추가 → INSERT 예정
}
상품 10번이 카테고리 5번에 연결된 상태에서, 카테고리 5번 그대로 수정 요청이 들어오면 내가 기대한 SQL 순서는 이랬다.
DELETE FROM products_categories WHERE id = 1;                -- 기존 (10, 5) 삭제
INSERT INTO products_categories (product_id, category_id) VALUES (10, 5);  -- 다시 추가
하지만 실제 SQL 로그는 반대였다.
INSERT INTO products_categories (product_id, category_id) VALUES (10, 5);  -- 이미 (10, 5)가 있음 → UNIQUE 위반
-- DELETE는 실행되지 못함
원인: Hibernate는 코드 순서대로 flush하지 않는다
Hibernate는 트랜잭션 커밋 시점에 쓰기 지연 저장소에 쌓인 SQL을 flush하는데, 이때 코드에 쓴 순서가 아니라 액션 타입별로 정해진 순서대로 실행한다. 대략 다음 순서다.
INSERT
UPDATE
컬렉션 변경
DELETE
즉 clear()를 먼저 호출했어도, flush 시점에는 새 연결의 INSERT가 기존 연결의 DELETE보다 먼저 나간다. 다른 카테고리로 바꿀 때는 (10, 5)와 (10, 7)이 서로 다른 쌍이라 충돌이 없었지만, 같은 카테고리일 때는 지워지기 전의 (10, 5) 위에 같은 (10, 5)를 INSERT하면서 UNIQUE 제약에 걸린 것이다.
"다른 값으로 바꾸면 되는데 같은 값이면 터진다"는 기묘한 증상의 정체가 여기에 있었다.
해결: 충돌 상황을 애초에 만들지 않기
clear 후 add 대신, 지울 것만 지우고 없을 때만 추가하는 방식으로 바꿨다.
// Product.java
public void changeCategory(Category newCategory) {
    // 새 카테고리가 아닌 연결만 제거 (orphanRemoval = true라서 리스트에서 빠지면 DELETE)
    productCategories.removeIf(pc -> !pc.getCategory().getId().equals(newCategory.getId()));
    // 남은 게 없으면 (= 원래 다른 카테고리였으면) 새로 연결
    if (productCategories.isEmpty()) {
        addCategory(newCategory);
    }
}
케이스별 동작은 이렇다.
요청
removeIf (새 카테고리가 아닌 것 제거)
isEmpty면 추가
실행 SQL
5 → 5 (같음)
지울 게 없음
비어 있지 않아 추가 안 함
없음
5 → 7 (다름)
(10, 5) 제거
비었으니 (10, 7) 추가
INSERT (10, 7), DELETE (10, 5) — 쌍이 달라 충돌 없음
같은 카테고리면 아무 SQL도 나가지 않고, 다른 카테고리면 INSERT가 먼저 실행되더라도 서로 다른 쌍이라 UNIQUE에 걸리지 않는다. flush 순서를 건드리는 게 아니라 충돌이 가능한 상황 자체를 제거하는 해법이다.
다른 해법들과 비교
이 문제를 푸는 방법이 조건부 교체만 있는 건 아니다.
중간에 flush 강제하기 — clear() 후 entityManager.flush()를 호출해 DELETE를 먼저 DB에 보내고 add하는 방법. 동작은 하지만 쿼리가 불필요하게 두 번 나가고, flush 시점을 제어하는 인프라성 코드가 도메인 로직에 섞인다.
PostgreSQL DEFERRABLE 제약 — UNIQUE 제약을 DEFERRABLE INITIALLY DEFERRED로 선언하면 제약 검사가 커밋 시점으로 미뤄져서 트랜잭션 중간의 일시적 중복이 허용된다. 근본적인 해법이지만 DB에 종속적이고, 제약 하나 때문에 스키마 설계가 복잡해진다.
과제 수준에서는 애플리케이션 코드만으로 해결되고 불필요한 SQL도 없는 조건부 교체가 가장 깔끔하다고 판단했다.
정리
Hibernate는 flush 시 코드 순서가 아니라 INSERT → UPDATE → 컬렉션 변경 → DELETE 순서로 SQL을 실행한다.
컬렉션을 clear() 후 add()하는 패턴은 UNIQUE 제약과 만나면 "같은 값으로 수정할 때만" 터지는 찾기 어려운 버그가 된다.
flush 순서와 싸우기보다, 변경이 없으면 SQL이 나가지 않는 구조로 로직을 설계하는 편이 안전하다.
예제의 테이블과 데이터는 모두 설명을 위해 만든 가상의 것. 아래 실행 결과는 MariaDB 10.11과 Java 21에서 직접 실행한 값.
요약
증상: 리포트에서 app 채널이 0건으로 표시된다. 그런데 표의 행을 모두 합치면 전체 합계보다 12만 건이 모자란다
원인: ① DB의 대소문자 무시 collation이 app과 APP을 한 그룹으로 합치고 대표 라벨을 어느 쪽으로 고를지 보장하지 않는다, ② Java의 HashMap은 대소문자를 구분한다
해결: 데이터를 고치지 않고 조회 단에서 정규화(LOWER)하고, 애플리케이션에서도 한 번 더 막는다(이중 방어). 미분류 항목은 경고 로그로 남긴다
교훈: 같은 값이 DB와 Java에서 서로 다르게 해석된다. 값이 계층을 넘어갈 때마다 "여기서는 어떻게 비교하는가"를 명시해야 한다
1. 상황 설정
채널별 월간 주문 건수를 집계한 테이블을 읽어 월간 리포트를 만든다. 값은 대부분 소문자인데, 외부 제휴 피드가 넣은 2건만 대문자다.
CREATE TABLE channel_stat (
  id        INT AUTO_INCREMENT PRIMARY KEY,
  month_key CHAR(6)     NOT NULL,
  channel   VARCHAR(20) NOT NULL,   -- 기본 collation: utf8mb4_general_ci
  order_cnt INT         NOT NULL
);

INSERT INTO channel_stat (month_key, channel, order_cnt) VALUES
 ('202609', 'web',  50000),
 ('202609', 'app', 120000),
 ('202609', 'APP',      2);        -- 제휴 피드가 대문자로 적재
app과 APP은 바이트로는 서로 다른 값이다.
2. 증상: 리포트에서 app이 0건이다
리포트는 채널별 합계를 Map에 담고 이름으로 값을 찾는다.
// SELECT channel, SUM(order_cnt) FROM channel_stat WHERE month_key = ? GROUP BY channel
Map<String, Integer> byChannel = rows.stream()
        .collect(Collectors.toMap(Row::channel, Row::orders));

byChannel.getOrDefault("app", 0);   // 0 ← 12만 건이 있는데?
표의 합(50,000)이 월 전체 합계(170,002)보다 120,002건 모자란다. 건수가 없는 게 아니라 표의 어떤 행에도 매칭되지 않는 이름 아래에 있다는 단서다. DB로 내려가 확인해 보자.
2. 원인 ①: DB는 대소문자를 구분하지 않는다
SELECT channel, SUM(order_cnt) AS total FROM channel_stat GROUP BY channel;
+---------+--------+
| channel | total  |
+---------+--------+
| app     | 120002 |
| web     |  50000 |
+---------+--------+
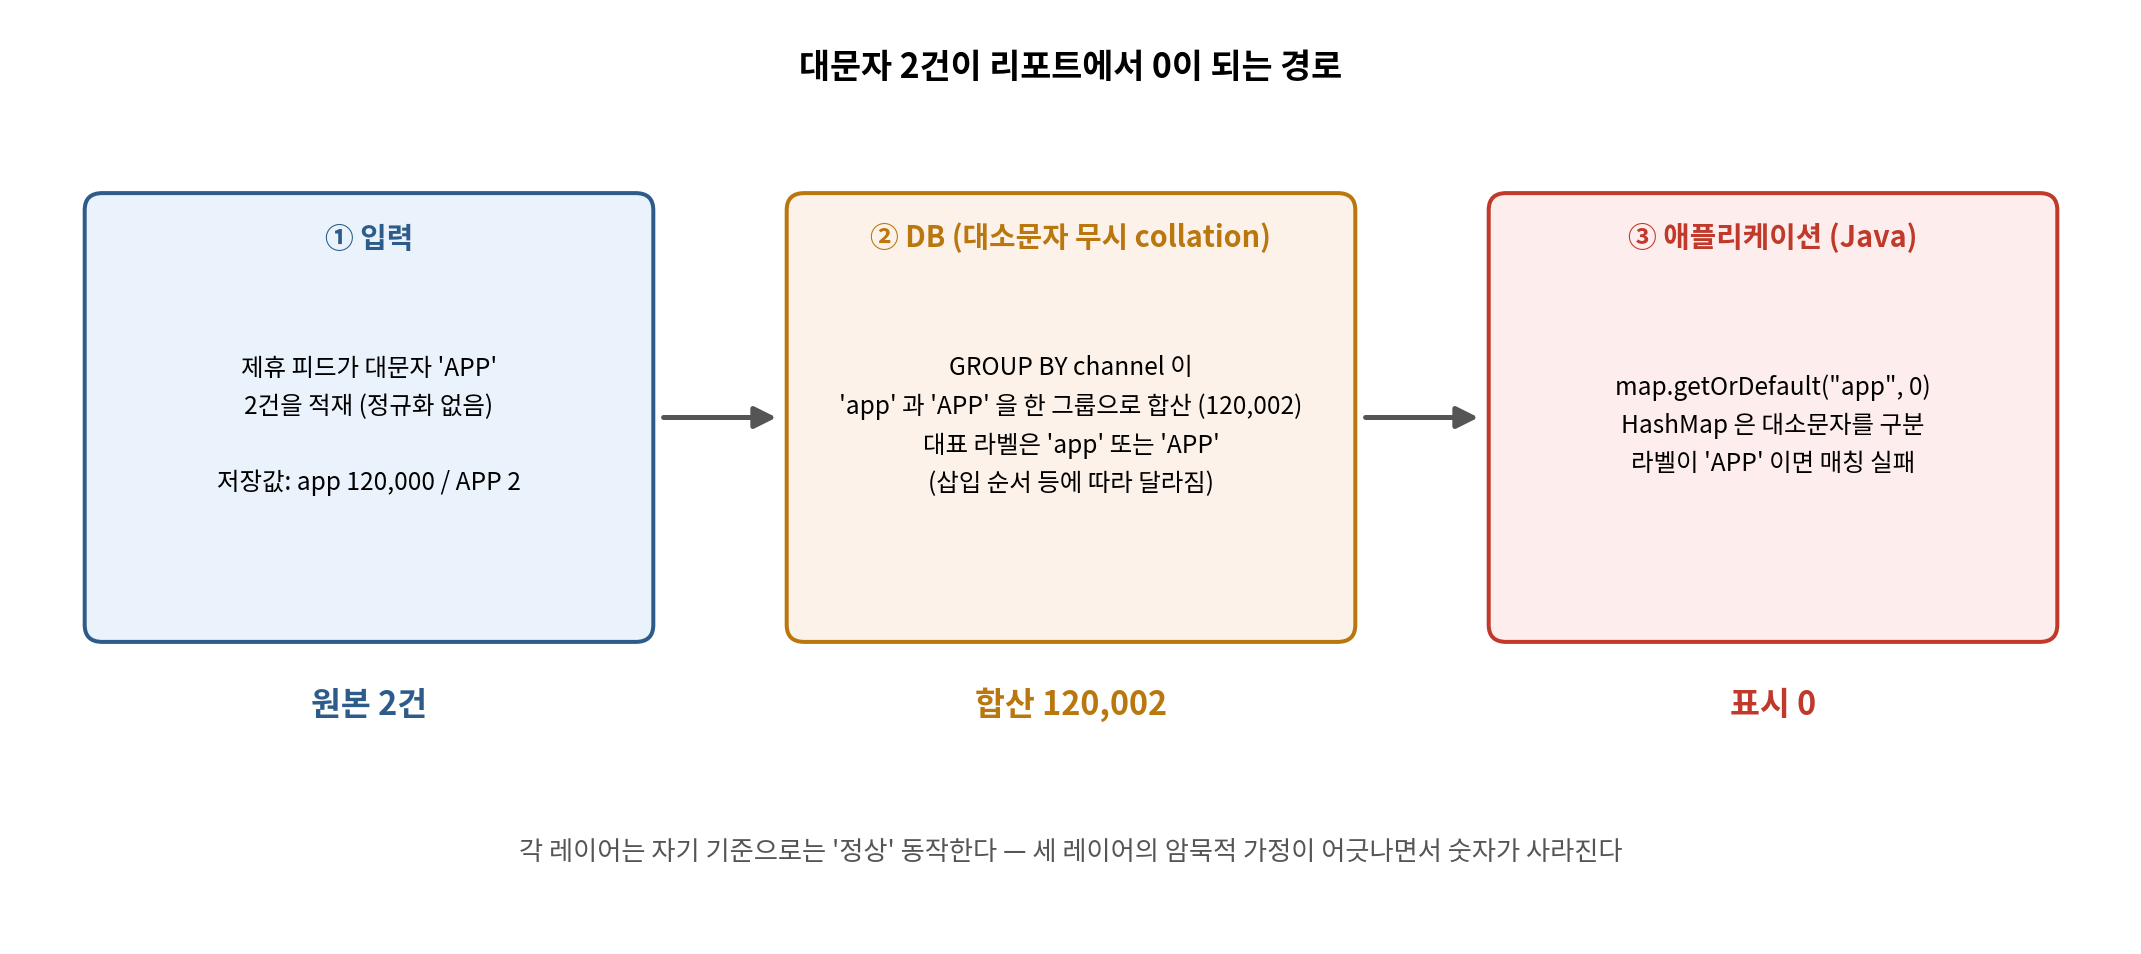
app(12만)과 APP(2)이 한 그룹으로 합쳐져 120,002가 됐다. MariaDB의 기본 collation(utf8mb4_general_ci)은 대소문자를 구분하지 않기 때문이다. (MySQL 8의 기본 utf8mb4_0900_ai_ci도 대소문자를 구분하지 않는다.) WHERE도 마찬가지다.
SELECT channel, order_cnt FROM channel_stat WHERE channel = 'app';
그런데 이 결과에는 더 위험한 성질이 숨어 있다. 합쳐진 그룹의 대표 라벨을 DB가 어떻게 고르는가다. 같은 데이터를 삽입 순서만 바꿔서 넣어 보자.
CREATE TABLE channel_stat2 LIKE channel_stat;
INSERT INTO channel_stat2 (month_key, channel, order_cnt) VALUES
 ('202609', 'APP',      2),        -- 대문자 행이 먼저
 ('202609', 'web',  50000),
 ('202609', 'app', 120000);

SELECT channel, SUM(order_cnt) AS total FROM channel_stat2 GROUP BY channel;
+---------+--------+
| channel | total  |
+---------+--------+
| APP     | 120002 |       ← 라벨이 'APP' 으로 바뀌었다
| web     |  50000 |
+---------+--------+
숫자(120,002)는 같지만 라벨이 app에서 APP으로 바뀌었다. 어떤 라벨이 나올지는 삽입 순서, 실행 계획 같은 조건에 따라 달라질 수 있고, 코드가 거기에 의존해서는 안 된다.
"app"과 "APP"은 String.equals 기준으로 다른 키다. 리포트는 "app"을 찾고, DB는 "APP"을 줬으니 매칭에 실패하고 기본값 0이 표시된다.
4. 세 레이어의 암묵적 가정
그림 2. 각 레이어는 자기 기준으로는 정상 동작한다. 가정이 서로 달랐을 뿐이다.
입력: 외부 피드가 대문자를 적재했다. 저장 시점에 정규화가 없었다.
DB: collation 규칙에 따라 두 값을 같다고 보고 합산했다. 대표 라벨은 보장되지 않는다.
애플리케이션: equals 규칙에 따라 두 값을 다르다고 보고 매칭에 실패했다.
어느 레이어도 버그가 아니다. 레이어마다 "같다"의 정의가 다른데, 아무도 그 사실을 명시하지 않았다는 것이 문제의 본질이다. 그래서 단 2건의 데이터가 12만 건짜리 표시 오류로 증폭된다.
5. 해결 선택지 비교
방법
언제 적합한가
주의할 점
A. 조회 정규화 (LOWER(col) + Java toLowerCase)
값이 의미상 대소문자와 무관하고, 데이터를 건드리고 싶지 않을 때
컬럼에 함수를 씌우면 일반적으로 인덱스를 쓰지 못한다
B. BINARY 그룹핑
대소문자가 의미 있는 구분자일 때 (예: app과 APP이 서로 다른 출처)
ONLY_FULL_GROUP_BY에서 MAX() 필요 (아래)
C. 저장 시점 정규화 (INSERT 전 변환 + 기존 데이터 백필)
근본 해결을 원하고, 입력 경로를 우리가 통제할 수 있을 때
기존 데이터 백필, 원천 데이터의 소유권, 배포 범위가 부담이다
D. 컬럼 collation을 *_bin으로 변경
해당 컬럼의 모든 비교가 대소문자를 구분해야 할 때
정렬·유니크·조인 등 모든 비교에 영향을 주므로 영향 분석이 필수다
E. 입력 제약 (CHECK, 코드 테이블)
잘못된 값이 아예 못 들어오게 막고 싶을 때
CHECK 작성에 함정이 있다 (아래)
A. 조회 정규화
SELECT LOWER(channel) AS channel, SUM(order_cnt) AS total
FROM channel_stat GROUP BY LOWER(channel);
+---------+--------+
| channel | total  |
+---------+--------+
| app     | 120002 |
| web     |  50000 |
+---------+--------+
라벨이 항상 소문자로 고정되니 Java에서도 "app"으로 찾을 수 있다.
B. BINARY 그룹핑과 ONLY_FULL_GROUP_BY
대소문자를 구분해서 그룹핑하려면 GROUP BY BINARY channel을 쓸 수 있다. 그런데 ONLY_FULL_GROUP_BY가 켜져 있으면 이렇게 쓸 수 없다. (MySQL 5.7+는 기본으로 켜져 있고, MariaDB는 기본으로 꺼져 있다. 아래는 켠 상태에서 실행했다.)
SELECT channel, SUM(order_cnt) FROM channel_stat GROUP BY BINARY channel;
-- ERROR 1055 (42000): 'demo_collation.channel_stat.channel' isn't in GROUP BY
그룹 키는 BINARY channel인데 SELECT에는 channel이 있어서 서로 다른 식으로 취급되기 때문이다. MAX()로 감싸 "그룹 안에서 값은 모두 같다"고 알려주면 된다.
SELECT MAX(channel) AS channel, SUM(order_cnt) AS total
FROM channel_stat GROUP BY BINARY channel;
이제 app과 APP이 분리됐다. 이 방식이 맞는지는 두 값이 정말 다른 의미인지에 달려 있다. 같은 채널의 표기 차이일 뿐이라면 A가 맞다.
D. COLLATE를 쓸 때는 컬럼의 문자셋을 확인한다
COLLATE는 컬럼의 문자셋과 짝이 맞아야 한다. 컬럼이 utf8mb3인데 흔히 보이는 utf8mb4_bin을 쓰면 이렇게 실패한다.
-- channel 컬럼이 CHARACTER SET utf8mb3 인 경우
SELECT channel, COUNT(*) FROM channel_stat3 GROUP BY channel COLLATE utf8mb4_bin;
-- ERROR 1253 (42000): COLLATION 'utf8mb4_bin' is not valid for CHARACTER SET 'utf8mb3'
컬럼의 문자셋에 의존하지 않으려면 BINARY를 쓰는 편이 안전하다.
E. 소문자만 허용하는 CHECK의 함정
"소문자만 들어오게 막자"며 이렇게 쓰기 쉽다.
CREATE TABLE chk1 (channel VARCHAR(20) NOT NULL, CHECK (channel = LOWER(channel)));
INSERT INTO chk1 VALUES ('app');
INSERT INTO chk1 VALUES ('APP');      -- 통과해 버린다!
기본 collation에서는 'APP' = LOWER('APP')도 참이라서 제약이 아무것도 막지 못한다. 바이트로 비교해야 한다.
CREATE TABLE chk2 (channel VARCHAR(20) NOT NULL, CHECK (BINARY channel = LOWER(channel)));
INSERT INTO chk2 VALUES ('app');
INSERT INTO chk2 VALUES ('APP');
-- ERROR 4025 (23000): CONSTRAINT `CONSTRAINT_1` failed for `demo_collation`.`chk2`
7. 방어 코드: 한쪽이 틀어져도 리포트가 죽지 않게
DB 쿼리를 LOWER로 고쳤더라도, 누군가 쿼리를 되돌리거나 다른 경로에서 대소문자가 섞인 데이터가 들어올 수 있다. 애플리케이션에도 한 겹 더 방어를 둔다.
// 키를 소문자로 정규화하고, 같은 키가 충돌하면 합산한다
Map<String, Integer> safe = rows.stream().collect(Collectors.toMap(
        r -> r.channel().toLowerCase(Locale.ROOT),
        Row::orders,
        Integer::sum));

System.out.println(safe.getOrDefault("app", 0));   // 120002
병합 함수(Integer::sum)가 없으면 키가 충돌하는 순간 예외가 나서 리포트 발송 자체가 죽는다.
CREATE TABLE categories (
  id        BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  name      VARCHAR(100) NOT NULL,
  parent_id BIGINT REFERENCES categories(id)   -- 자기 참조 FK
);
의류(1) → 상의(2) → 티셔츠(3)
여기서 의류의 부모를 티셔츠로 바꾸면 의류 → 티셔츠 → 상의 → 의류로 닫힌 고리가 생깁니다. 이 상태가 저장되면 루트를 찾아 올라가는 모든 조회가 무한 루프에 빠집니다.
DB 제약으로 막을 수 있는지도 확인했습니다. CHECK (id <> parent_id)를 걸면 직접 자기 참조는 막히지만, 간접 순환은 그대로 통과합니다. 그래서 간접 순환은 애플리케이션이나 쿼리에서 검증해야 합니다.
CREATE TABLE c2 (
    id BIGINT PRIMARY KEY,
    parent_id BIGINT REFERENCES c2(id),
    CONSTRAINT chk_no_self_parent CHECK (id <> parent_id)
);
INSERT INTO c2 VALUES (1, NULL), (2, 1);

UPDATE c2 SET parent_id = 2 WHERE id = 2;  -- ERROR: violates check constraint
UPDATE c2 SET parent_id = 2 WHERE id = 1;  -- 성공. 1 → 2 → 1 순환이 저장됨
이 글에서 다루는 케이스는 다섯 가지입니다.
요청
순환 여부
의류를 의류 아래로 (자기 자신)
O
의류를 상의 아래로 (자식)
O
의류를 티셔츠 아래로 (손자)
O
티셔츠를 무관한 카테고리 아래로
X
티셔츠를 의류 아래로 (조상 쪽으로 이동)
X
2. 구현: 조상을 타고 올라가며 검증
코드
새 부모에서 출발해 parent를 따라 루트까지 올라가면서, 수정 대상 카테고리를 만나는지 확인합니다. 만나면 대상이 새 부모의 조상이라는 뜻이므로 그 아래로 옮기면 순환이 됩니다.
검증과 변경을 엔티티의 도메인 메서드에 두었습니다. 외부에서 부모를 임의로 바꿀 수 없게 하고, 검증과 변경이 항상 같이 실행되도록 하기 위해서입니다.
public void update(String name, String description, Category newParent) {
    validateParent(newParent);
    this.name = name;
    this.description = description;
    changeParent(newParent);
}

private void validateParent(Category newParent) {
    Category current = newParent;
    while (current != null) {                         // 루트(parent == null)까지 올라감
        if (current.getId().equals(this.id)) {        // 조상 중에 내가 있으면 순환
            throw new DomainException(DomainExceptionCode.CATEGORY_CIRCULAR_REFERENCE);
        }
        current = current.getParent();
    }
}

private void changeParent(Category newParent) {
    if (this.parent != null) this.parent.children.remove(this);  // 양방향 연관관계 정리
    this.parent = newParent;
    if (newParent != null) newParent.children.add(this);
}
@Transactional
public CategoryUpdateResponse updateCategory(Long categoryId, CategoryUpdateRequest dto) {
    //... 중략
    category.update(dto.getName(), dto.getDescription(), parent);  // 순환 검증 포함
    // ... 중략
}
몇 가지 설계 포인트
자기 자신 지정도 같은 루프에서 잡힙니다.current가 처음에 newParent이므로, newParent == this이면 첫 반복에서 걸립니다. 직접 순환과 간접 순환을 따로 검사할 필요가 없습니다.
비교는 인스턴스(==)가 아니라 id로 합니다. LAZY 연관은 프록시일 수 있어서 같은 행이라도 인스턴스가 다를 수 있습니다.
parentId = null은 "루트로 이동"입니다. PUT은 전체 교체이므로 null을 "변경 없음"으로 해석하지 않고, 검증 루프는 newParent == null이면 바로 종료됩니다.
앞의 다섯 케이스를 이 로직에 대입해 보면, 자기 자신·자식·손자는 올라가는 도중에 this를 만나 예외가 되고, 무관한 이동과 조상 쪽 이동은 루트까지 올라가도 만나지 않아 통과합니다. (같은 다섯 케이스를 4장에서 SQL로 실제 실행해 검증합니다.)
3. 한계 ①: 깊이만큼 DB 왕복이 생긴다
parent는 @ManyToOne(fetch = LAZY)입니다. LAZY 프록시는 접근하는 순간 초기화되므로, current.getParent()로 한 단계 올라갈 때마다 SELECT가 한 번씩 나가는 구조입니다. 프로젝트에 켜 둔 org.hibernate.SQL: DEBUG 로그에서 조상 단계마다 categories 조회가 찍히는지 확인할 수 있습니다.
깊이가 얼마나 영향을 주는지 보려고, 같은 구조(한 단계 올라갈 때마다 DB 왕복 1회)와 재귀 CTE 한 번 호출을 PostgreSQL에서 비교했습니다. Hibernate의 오버헤드는 뺀 DB 왕복 구조만의 비교입니다.
실험 조건: PostgreSQL 16, 무관한 행 10만 개와 깊이 D의 체인, 단일 연결, 로컬 소켓. 체인의 맨 아래 노드에서 올라가며 "무관한 카테고리가 조상에 있는지"를 확인합니다(순환이 아닌 경우라 끝까지 올라갑니다). 반복 200회(깊이 1000은 30회)의 중앙값입니다.
깊이
단계별 조회 (쿼리 수)
단계별 조회 (중앙값)
재귀 CTE (쿼리 1회, 중앙값)
5
5회
0.52 ms
0.13 ms
20
20회
2.10 ms
0.17 ms
100
100회
10.37 ms
0.37 ms
1000
1000회
98.57 ms
1.85 ms
단계별 조회는 깊이에 정비례하고, 이 환경에서는 왕복 한 번에 약 0.1ms가 듭니다. DB가 같은 호스트의 소켓이라 왕복 비용이 매우 작은 조건이므로, DB가 네트워크 너머에 있으면 왕복 횟수만큼 격차가 더 벌어질 것입니다.
다만 이 프로젝트의 카테고리는 예시 데이터 기준 대/중/소 3단계이고, 수정은 어드민에서만 가끔 일어납니다. 이 규모에서는 이 비용이 문제가 되지 않습니다. 깊이 제한이 없거나 깊은 트리를 다뤄야 하는 요구사항에서 문제가 됩니다.
4. 개선: 재귀 CTE로 한 번에 확인
쿼리
조상을 따라 올라가는 일을 DB에 맡기면 왕복이 한 번으로 줄어듭니다.
WITH RECURSIVE ancestors(id, parent_id) AS (
    SELECT id, parent_id FROM categories WHERE id = :newParentId    -- 새 부모에서 출발
    UNION
    SELECT c.id, c.parent_id
    FROM categories c
    JOIN ancestors a ON c.id = a.parent_id                          -- 한 단계 위로
)
SELECT EXISTS (SELECT 1 FROM ancestors WHERE id = :targetId)        -- 대상이 조상(또는 본인)에 있는가
UNION ALL이 아니라 UNION을 쓴 데는 이유가 있습니다. 이미 순환이 저장된 데이터가 있을 때 두 방식이 어떻게 다른지 확인했습니다(a ↔ b를 서로의 부모로 강제로 만든 뒤 실행).
방식
결과
UNION
중복 행을 제거하므로 순환 데이터에서도 종료 (결과 false)
UNION ALL
무한 재귀 → statement_timeout(1.5초)으로 QueryCanceled
검증 쿼리가 오염된 데이터 때문에 서버를 붙잡는 상황을 피할 수 있습니다.
정확성 검증
앞의 다섯 케이스를 같은 데이터에 실행해서 모두 기대 결과와 일치하는 것을 확인했습니다 (R → A → B → C와 무관한 X).
요청
CTE 결과
기대
A를 A 아래로
순환
순환
A를 B 아래로
순환
순환
A를 C 아래로
순환
순환
C를 X 아래로
순환 아님
순환 아님
B를 R 아래로
순환 아님
순환 아님
실행 계획
깊이 100인 체인에서 EXPLAIN (ANALYZE, BUFFERS) 결과의 핵심 부분입니다.
Recursive Union (actual rows=100 loops=1)
  ->  Index Scan using categories_pkey on categories (actual rows=1 loops=1)
  ->  Nested Loop (actual rows=1 loops=100)
        ->  WorkTable Scan on ancestors a (actual rows=1 loops=100)
        ->  Index Scan using categories_pkey on categories c (actual rows=1 loops=100)
Execution Time: 0.255 ms
10만 행 테이블인데도 풀 스캔 없이 PK 인덱스 탐색을 깊이만큼(loops=100) 반복할 뿐입니다. 재귀를 DB 안에서 수행하므로 왕복 비용이 사라지고, 남는 것은 인덱스 탐색 비용이며 이는 앞의 표에서 깊이 1000에서도 1.85ms였습니다.
JPA 적용 예시
public interface CategoryRepository extends JpaRepository<Category, Long> {

    @Query(nativeQuery = true, value = """
            WITH RECURSIVE ancestors(id, parent_id) AS (
                SELECT id, parent_id FROM categories WHERE id = :startId
                UNION
                SELECT c.id, c.parent_id
                FROM categories c
                JOIN ancestors a ON c.id = a.parent_id
            )
            SELECT EXISTS (SELECT 1 FROM ancestors WHERE id = :candidateId)
            """)
    boolean isSelfOrAncestor(@Param("startId") Long startId, @Param("candidateId") Long candidateId);
}
// 서비스: 검증은 쿼리에 맡기고, 엔티티는 값 변경만 담당
if (parent != null && categoryRepository.isSelfOrAncestor(parent.getId(), categoryId)) {
    throw new DomainException(DomainExceptionCode.CATEGORY_CIRCULAR_REFERENCE);
}
category.update(dto.getName(), dto.getDescription(), parent);   // validateParent 호출은 제거
트레이드오프
네이티브 쿼리라 DB 종속입니다.WITH RECURSIVE 자체는 표준 SQL이지만, 표준 JPQL에는 CTE 문법이 없어 네이티브 쿼리로 작성해야 합니다.
쿼리는 영속성 컨텍스트가 아니라 DB를 봅니다. 같은 트랜잭션에서 앞서 부모를 바꾸고 아직 flush하지 않았다면 그 변경은 CTE에 보이지 않습니다. 엔티티를 직접 타고 올라가는 방식은 메모리 상태를 보기 때문에 이 문제가 없습니다. 한 트랜잭션에서 여러 카테고리를 연속으로 옮기는 배치성 기능이라면 검증 전에 flush()가 필요합니다.
도메인 규칙이 엔티티에서 서비스(쿼리)로 이동합니다. 불변식을 엔티티가 책임진다는 장점은 줄어듭니다.
5. 한계 ②: 동시에 수정하면 검증이 뚫린다
깊이와 별개로, 지금까지의 검증에는 근본적인 구멍이 하나 더 있습니다. 검증은 요청 시점의 DB 상태를 보고 통과 여부를 판단하는데, 그 사이에 다른 트랜잭션이 상태를 바꿀 수 있다는 점입니다.
시나리오
A와 B가 둘 다 루트일 때, 두 관리자가 동시에 서로를 부모로 지정합니다.
순서
트랜잭션 1
트랜잭션 2
1
A를 B 아래로: 검증 (B의 조상에 A 없음, 통과)
2
B를 A 아래로: 검증 (A의 조상에 B 없음, 통과)
3
UPDATE A SET parent_id = B
4
UPDATE B SET parent_id = A
5
COMMIT
COMMIT
각 트랜잭션은 자기가 검증하는 시점에 상대의 변경이 커밋되지 않았으므로 문제를 보지 못하고, 갱신하는 행도 A와 B로 서로 달라서 행 락 충돌도 없습니다. 결과는 A.parent = B, B.parent = A 순환입니다.
PostgreSQL 16에서 READ COMMITTED(기본 격리 수준)로 위 순서를 그대로 실행하면 두 COMMIT이 모두 성공하고 [(1, 'A', 2), (2, 'B', 1)]이 저장됩니다.
대응 방식 비교
같은 시나리오를 방식별로 3회씩 반복 실행했습니다. 어느 쪽 트랜잭션이 성공하는지는 실행마다 달랐지만, 순환이 생기는지 여부는 매번 같았습니다.
방식
결과
비고
보호 없음
두 트랜잭션 모두 성공, 순환 발생
버전 컬럼(@Version 방식, UPDATE ... WHERE version = ?)
두 트랜잭션 모두 성공, 순환 발생
두 트랜잭션이 서로 다른 행을 수정하므로 버전 충돌이 일어나지 않음
어드바이저리 락으로 직렬화
한쪽은 순환으로 거부되고 한쪽만 성공, 순환 없음
두 번째 트랜잭션이 락을 기다렸다가 첫 번째의 커밋 결과를 보고 검증
SERIALIZABLE 격리 수준
한쪽은 SerializationFailure, 한쪽만 성공, 순환 없음
실패한 쪽은 애플리케이션이 재시도해야 함
@Version을 걸면 동시 수정이 해결될 것으로 기대하기 쉽지만, 낙관적 락은 같은 행을 동시에 고치는 충돌만 잡습니다. 이 문제는 서로 다른 행을 고치는 두 변경이 합쳐져서 불변식을 깨뜨리는 유형이라 막지 못했습니다.
적용 예시: 어드바이저리 락
계층 구조 변경 전체를 한 줄로 세우는 방법입니다. 트랜잭션이 끝나면 락이 자동으로 풀립니다.
public interface CategoryRepository extends JpaRepository<Category, Long> {

    @Query(nativeQuery = true, value = "SELECT 1 FROM (SELECT pg_advisory_xact_lock(:key)) t")
    int lockCategoryTree(@Param("key") long key);
}
@Transactional
public CategoryUpdateResponse updateCategory(Long categoryId, CategoryUpdateRequest dto) {
    categoryRepository.lockCategoryTree(CATEGORY_TREE_LOCK_KEY);   // 첫 쿼리로 락 획득
    // ... 이후 기존 로직 (검증 → 수정)
}
pg_advisory_xact_lock은 반환 타입이 void라서, 결과를 받기 쉽도록 서브쿼리로 감싸 정수 1을 반환하게 했습니다.
선택 기준
카테고리 구조 변경은 어드민이 드물게 하는 작업이라면 어드바이저리 락 직렬화가 가장 단순합니다. 모든 계층 변경이 한 줄로 서므로 서브트리 단위로 락을 고민할 필요가 없습니다.
변경이 잦고 지연이 문제라면 SERIALIZABLE과 재시도 로직 조합을 고려할 수 있지만, 재시도 처리와 실패율 관리가 필요합니다.
이 프로젝트의 현재 구현에는 동시성 방어가 없습니다. 어드민 사용자가 소수인 환경이라 동시에 서로를 부모로 지정할 가능성이 낮다고 보고 이번 범위에는 넣지 않았으며, 운영 환경이라면 위의 락을 적용하겠습니다.
6. 다른 계층 모델링과의 비교
지금까지는 parent_id 하나만 가진 인접 리스트 모델에서 검증하는 방법을 다뤘습니다. 모델 자체를 바꾸는 선택지도 있어서 비교해 두었습니다. 이 표는 일반적인 설계 패턴과 공식 문서를 기준으로 정리한 것이고, 이 프로젝트에서 직접 구현하거나 측정하지는 않았습니다.
모델
구조
순환 검증
조상/자손 조회
부모 이동 비용
참조 무결성
인접 리스트 (현재)
parent_id 컬럼
앱 로직 또는 재귀 CTE
재귀가 필요
한 행 수정
FK로 보장
Closure Table
모든 조상-자손 쌍을 별도 테이블에 저장
새 부모의 조상 집합에 자신이 있는지 단순 조회
조인 한 번
서브트리의 경로 행을 삭제 후 재삽입
FK로 보장
Materialized Path
/1/4/9/ 같은 경로 문자열 저장
새 부모 경로에 자신의 id가 포함되는지 확인
경로 접두사 검색
서브트리 전체의 경로 갱신
DB가 보장하지 못함
ltree (PostgreSQL 확장)
경로 전용 타입과 인덱스, 연산자 제공
경로 포함 연산자로 확인
연산자와 인덱스로 빠름
서브트리 전체의 경로 갱신
DB가 보장하지 못함
읽기(조상/자손 조회)가 압도적으로 많고 이동이 드물면 Closure Table이나 경로 기반 모델이 유리하지만, 이동 시 서브트리를 갱신해야 하고 저장 공간이나 정합성 관리 부담이 늘어납니다.
ltree는 확장 설치가 필요하고 JPA에서 쓰려면 커스텀 타입 매핑이 필요합니다.
쓰기가 단순하고 FK 무결성이 필요하면 인접 리스트가 유리하고, 부족한 읽기 성능은 재귀 CTE로 보완하는 경우가 많습니다.
7. 정리
항목
현재 구현
한계
보완 방향
순환 검증
조상을 타고 올라가는 도메인 메서드
깊이에 비례한 DB 왕복
재귀 CTE (1회 호출)
직접 자기 참조
애플리케이션 검증
CHECK (id <> parent_id) 추가 가능
간접 순환
애플리케이션 검증
DB 제약으로는 표현 불가
애플리케이션 검증 필수
동시 수정
방어 없음
서로 다른 행을 고치는 두 요청이 검증을 함께 통과
어드바이저리 락 직렬화 또는 SERIALIZABLE
현재 프로젝트는 대/중/소 3단계이고 수정이 드문 어드민 기능이라 조상 탐색 방식으로 충분합니다. 다만 아래 조건 중 하나라도 해당하면 방식을 바꾸는 것이 맞다고 판단합니다.
카테고리 깊이에 제한이 없거나 깊은 트리를 지원해야 한다 → 재귀 CTE로 전환
한 트랜잭션에서 여러 노드를 연속해서 이동한다 → 엔티티 탐색은 메모리 상태를, CTE는 DB 상태를 보므로 검증 시점의 flush 여부를 함께 설계
여러 사용자가 동시에 카테고리 구조를 편집한다 → 락 직렬화나 SERIALIZABLE 적용
조상/자손 조회가 매우 빈번하다 → Closure Table 등 모델 변경 검토
이번에 확인한 가장 중요한 점은 @Version처럼 익숙한 안전장치가 모든 동시성 문제를 막아주지는 않는다는 것입니다. "같은 행을 동시에 수정하는 문제"와 "서로 다른 행의 변경이 합쳐져서 불변식이 깨지는 문제"는 다른 종류이고, 후자는 검증이 읽는 범위까지 보호해야 해결됩니다.
부록: 재현 방법
스키마와 데이터 (깊이 100 체인, PostgreSQL)
CREATE TABLE categories (
    id        BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    name      VARCHAR(100) NOT NULL,
    parent_id BIGINT REFERENCES categories(id)
);

INSERT INTO categories(name) SELECT 'f' || g FROM generate_series(1, 100000) g;  -- 무관한 행 10만 개

DO $$
DECLARE prev BIGINT := NULL;
BEGIN
  FOR i IN 1..100 LOOP
    INSERT INTO categories(name, parent_id) VALUES ('n' || i, prev) RETURNING id INTO prev;
  END LOOP;
END $$;

INSERT INTO categories(name) VALUES ('target');
재귀 CTE 실행
SELECT max(id) AS tail_id FROM categories WHERE name LIKE 'n%' \gset
SELECT id AS target_id FROM categories WHERE name = 'target' \gset

EXPLAIN (ANALYZE, BUFFERS)
WITH RECURSIVE ancestors(id, parent_id) AS (
    SELECT id, parent_id FROM categories WHERE id = :tail_id
    UNION
    SELECT c.id, c.parent_id FROM categories c JOIN ancestors a ON c.id = a.parent_id
)
SELECT EXISTS (SELECT 1 FROM ancestors WHERE id = :target_id);
동시 수정 재현 (psql 세션 2개)
A, B가 모두 루트인 상태에서, 두 세션에서 아래를 순서대로 실행합니다. 각 세션에서 먼저 \set a <A의 id>, \set b <B의 id>로 변수를 지정합니다.
-- 세션 1                                   -- 세션 2
BEGIN;                                      BEGIN;
-- A를 B 아래로: B의 조상에 A가 있는가?
WITH RECURSIVE anc(id, parent_id) AS (
  SELECT id, parent_id FROM categories WHERE id = :b
  UNION
  SELECT c.id, c.parent_id FROM categories c JOIN anc a ON c.id = a.parent_id)
SELECT EXISTS (SELECT 1 FROM anc WHERE id = :a);   -- false
                                            -- B를 A 아래로: A의 조상에 B가 있는가?
                                            WITH RECURSIVE anc(id, parent_id) AS (
                                              SELECT id, parent_id FROM categories WHERE id = :a
                                              UNION
                                              SELECT c.id, c.parent_id FROM categories c JOIN anc a ON c.id = a.parent_id)
                                            SELECT EXISTS (SELECT 1 FROM anc WHERE id = :b);   -- false
UPDATE categories SET parent_id = :b WHERE id = :a;
                                            UPDATE categories SET parent_id = :a WHERE id = :b;
COMMIT;                                     COMMIT;

SELECT id, name, parent_id FROM categories WHERE id IN (:a, :b);   -- 서로를 부모로 가리킴
격리 수준을 BEGIN ISOLATION LEVEL SERIALIZABLE;로 바꾸면 두 번째 COMMIT에서 could not serialize access due to read/write dependencies among transactions 오류가 나는 것을 확인할 수 있습니다.
월 합계가 일 합계보다 작다. 쿼리는 멀쩡해 보이는데, 말일 하루치가 통째로 사라진다. 원인은 BETWEEN 한 줄에 숨어 있는 자릿수 불일치다. 이 글은 가상의 예제로 문제를 재현하고, 고치는 방법과 그 방법을 고르는 기준, 재발을 막는 검증 방법까지 정리한다.
예제의 테이블과 데이터는 모두 설명을 위해 만든 가상의 것이다. 아래 실행 결과는 MariaDB 10.11에서 직접 실행한 값이다.
요약
증상: 10분 단위 테이블에서 구한 월 합계(300)가 일 단위 요약의 합계(600)보다 작다
원인: yyyyMMddHHmmss 14자리 문자열 컬럼을 yyyyMMdd 8자리 값으로 BETWEEN 비교하면, 앞 8자리가 같을 때 더 긴 문자열이 더 커서 말일 전체가 범위 밖이 된다
해결: 상한을 "말일"이 아니라 "다음 달 1일(미포함)"로 두는 반열린 구간(>= from AND < to)을 쓴다
검증: 서로 다른 계층(10분 → 일 → 월)의 합계를 대조하는 쿼리를 두면 같은 종류의 누락을 바로 잡을 수 있다
1. 상황 설정
이벤트를 10분 단위로 집계한 테이블과, 이를 일 단위로 요약한 테이블이 있다고 하자. 날짜는 문자열 컬럼에 yyyyMMddHHmmss 형식으로 저장한다.
CREATE TABLE event_10min (
  slot CHAR(14) NOT NULL COMMENT 'yyyyMMddHHmmss',
  cnt  INT      NOT NULL,
  PRIMARY KEY (slot)
);

-- 4월 29일 마지막 슬롯, 4월 30일 슬롯 3개, 5월 1일 첫 슬롯 등 (건수는 모두 100)
INSERT INTO event_10min VALUES
 ('20260401000000', 100), ('20260415120000', 100), ('20260429235000', 100),
 ('20260430000000', 100), ('20260430120000', 100), ('20260430235000', 100),
 ('20260501000000', 100);

-- 일 단위 요약 (day 는 8자리)
CREATE TABLE event_daily (day CHAR(8) NOT NULL, cnt INT NOT NULL, PRIMARY KEY (day));
INSERT INTO event_daily
SELECT LEFT(slot, 8), SUM(cnt) FROM event_10min GROUP BY LEFT(slot, 8);
4월 한 달의 합계를 구하는 쿼리를 이렇게 썼다.
2. 증상: 월 합계가 일 합계보다 작다
-- 10분 단위 테이블에서 4월 합계
SELECT SUM(cnt) AS april_total FROM event_10min
WHERE slot BETWEEN '20260401' AND '20260430';
같은 4월인데 300과 600이다. 두 숫자 가운데 어느 쪽이 맞는지는, 일 단위 요약의 일별 값을 직접 합쳐 보면 확인할 수 있다(4월에 100건짜리 슬롯이 6개 있으니 600이 맞다).
여기서 중요한 단서가 하나 있다.
일 단위 요약은 맞고, 10분 단위 테이블에서 구한 값만 틀리다. 그리고 모자란 양(300)은 정확히 하루치(4/30의 슬롯 3개)다.
3. 원인: 자릿수가 다른 문자열의 비교
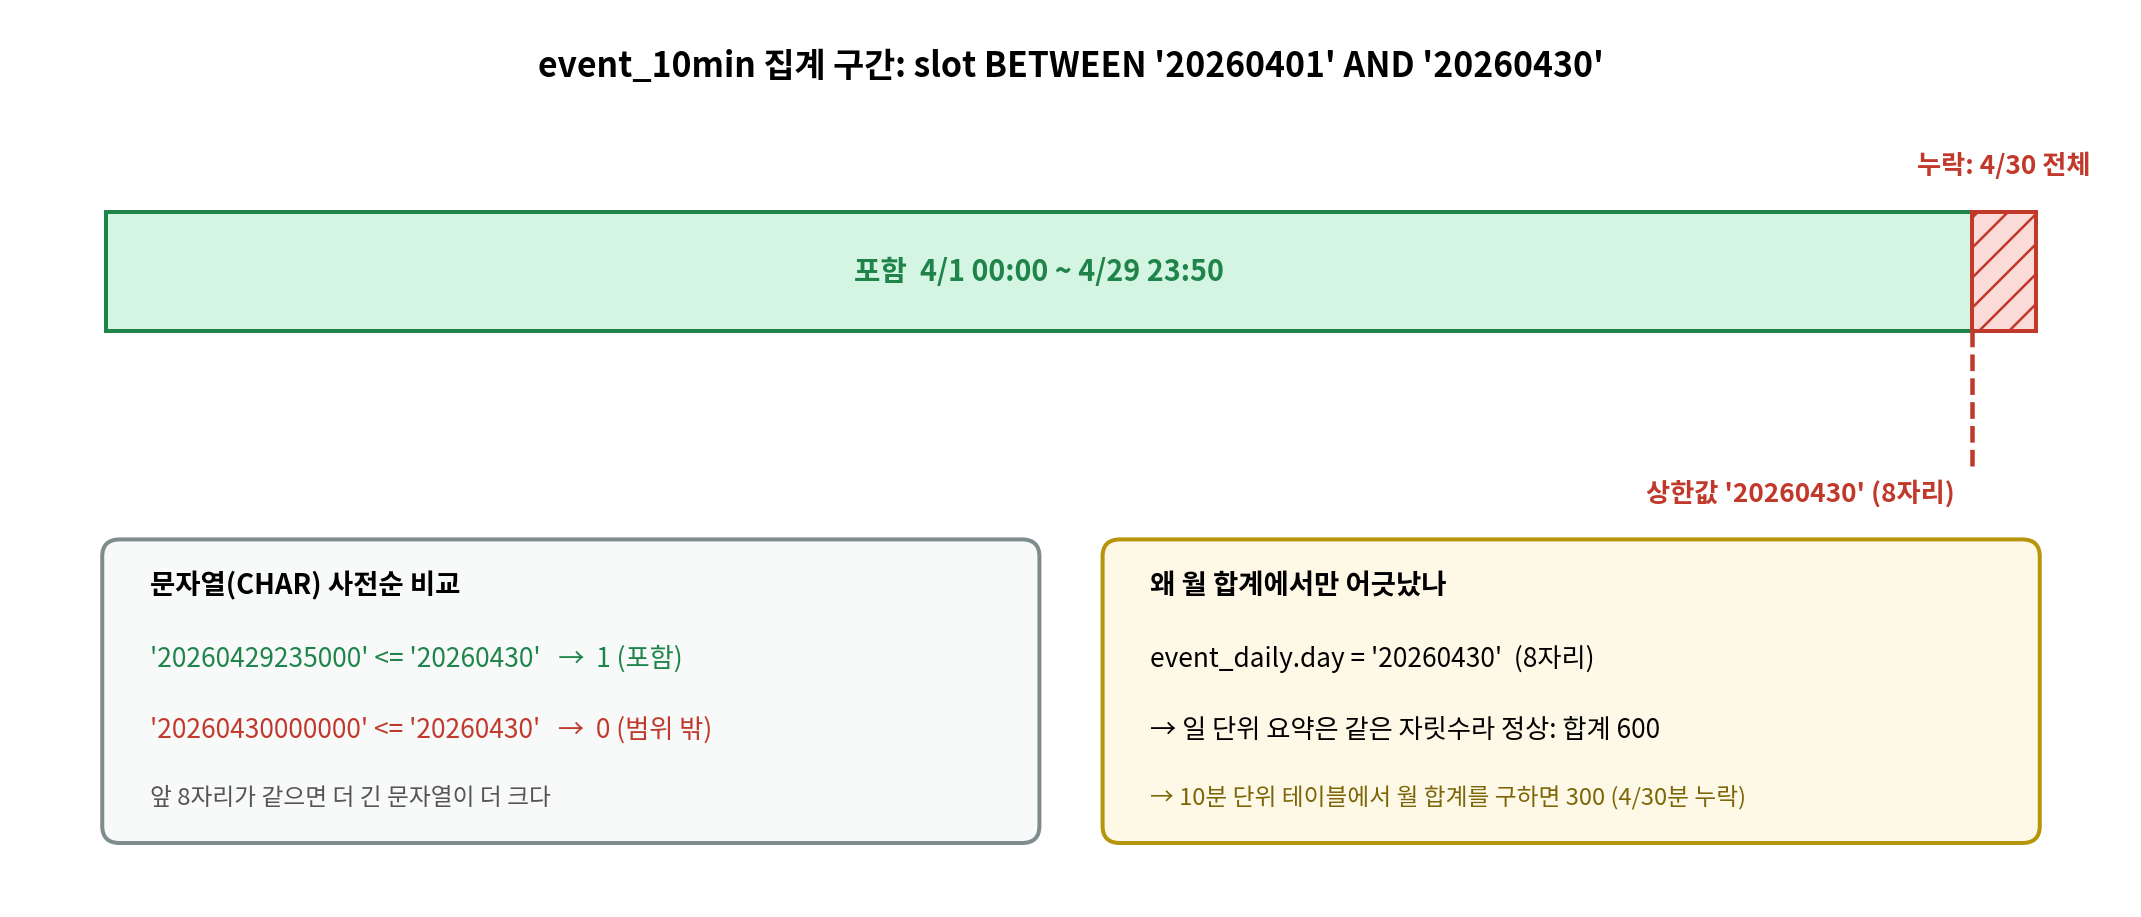
문자열 비교는 앞에서부터 한 글자씩 본다. 앞부분이 같으면 더 긴 문자열이 더 크다.
SELECT '20260430000000' <= '20260430' AS a,
       '20260429235000' <= '20260430' AS b;
+---+---+
| a | b |
+---+---+
| 0 | 1 |
+---+---+
'20260429235000' <= '20260430' → 4/29 행은 상한보다 작으니 포함
'20260430000000' <= '20260430' → 4/30 00:00:00조차 앞 8자리가 같고 더 길어서 상한보다 크다 → 범위 밖
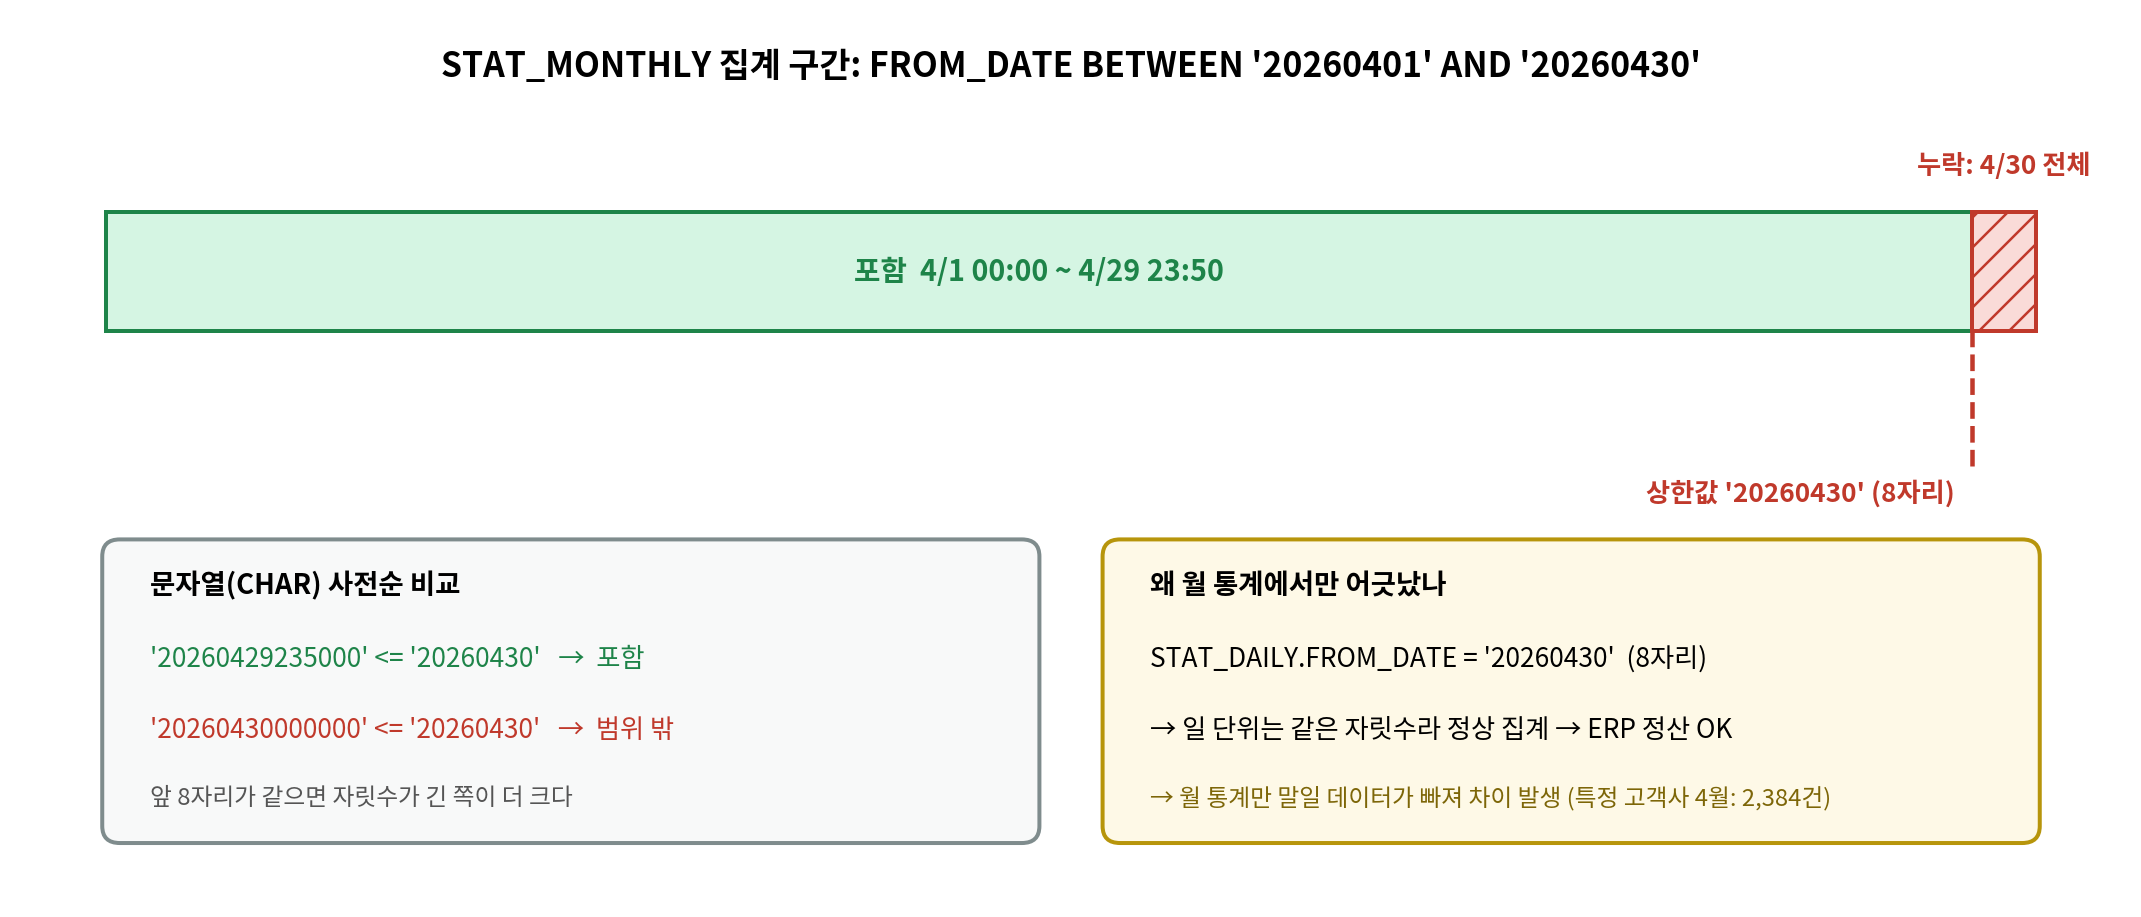
BETWEEN이 "상한을 포함한다"는 사실은 두 값의 형식이 같을 때만 의미가 있다. 상한이 8자리 '20260430'이면 4/30의 14자리 값은 하나도 들어오지 못한다.
그림 1. 상한값이 8자리라서 4/30의 14자리 값이 전부 범위 밖으로 밀려난다.
어느 날이 빠졌는지는 다음 쿼리로 바로 찾을 수 있다.
SELECT LEFT(slot, 8) AS day, SUM(cnt) AS cnt
FROM event_10min
WHERE LEFT(slot, 8) BETWEEN '20260401' AND '20260430'     -- 날짜만 잘라서 비교
  AND NOT (slot BETWEEN '20260401' AND '20260430')        -- 원래 조건에서는 빠지는 행
GROUP BY LEFT(slot, 8);
포함/미포함이 명확하다. "말일 23:59:59를 포함할까, 초 이하는?" 같은 고민이 사라진다.
구간이 겹치지도 비지도 않는다. 4월의 상한(미포함)이 5월의 하한(포함)과 정확히 같아서, 월을 이어 붙여도 누락·중복이 생기지 않는다.
상한 계산이 쉽다. 말일 대신 plusMonths(1).atDay(1)만 쓰면 되니 28/29/30/31일을 따질 필요가 없다.
5. 다른 해결 선택지와 비교
방법
장점
단점 / 주의
같은 자릿수 + 반열린 구간 (권장)
스키마 변경 없이 바로 적용, 인덱스 활용 가능
문자열 형식에 계속 의존한다
LEFT(slot, 8) BETWEEN ...
쿼리가 직관적이다
컬럼에 함수를 씌우면 일반적으로 인덱스를 쓰지 못한다
BETWEEN '...000000' AND '...235959'
형식은 맞는다
초 이하(밀리초) 정밀도로 바뀌면 다시 누락되고, 상한이 하드코딩된다
컬럼 타입을 DATETIME으로 변경
날짜 비교가 타입 수준에서 안전하다
데이터 이관과 모든 호출부의 변경이 필요하다
운영 중인 시스템에서 당장 고쳐야 한다면 첫 번째 방법이 변경 범위가 가장 작다. 새로 설계한다면 처음부터 날짜 타입을 쓰는 게 가장 좋다.
6. 재발을 막는 검증
이런 버그는 쿼리가 에러 없이 정상 동작해서 눈에 띄지 않는다. 사람이 이상하다고 말하기 전에 잡으려면 서로 다른 계층의 합계를 대조하는 쿼리가 있어야 한다.
-- 일 단위 요약 vs 10분 단위 원본 (월 기준)
SELECT d.day_sum, m.min_sum, d.day_sum - m.min_sum AS diff
FROM (SELECT SUM(cnt) AS day_sum FROM event_daily
       WHERE day >= '20260401' AND day < '20260501') d,
     (SELECT SUM(cnt) AS min_sum FROM event_10min
       WHERE slot >= '20260401000000' AND slot < '20260501000000') m;
-- diff 가 0 이 아니면 어느 계층에서 새고 있다는 신호
경계 계산 함수는 단위 테스트로 고정해 둔다. 말일, 연말, 윤년이 테스트 케이스의 핵심이다.
BETWEEN은 읽기 쉬워서 안심하게 되지만, 비교되는 두 값의 형식이 다르면 "범위"라는 직관이 깨진다. 문자열은 비교되는 순간에 의미가 정해진다. 다음 편에서는 같은 맥락으로, 대소문자를 구분하지 않는 DB와 구분하는 Java 사이에서 숫자가 사라지는 문제를 다룬다.
통계 정합성 시리즈 1/3 · 1편 월 통계 말일 누락 (이 글) · 2편 대소문자 2건이 만든 277만 건 표시 오류 · 3편 리포트 분류 기준 통합
고객사가 "월 통계와 일 통계의 숫자가 다르다"고 문의해 왔다. 원인은 SQL의 BETWEEN 한 줄이었다. 하지만 이 글은 그 한 줄을 찾은 이야기보다, 한 줄을 고치는 데서 멈추지 않은 이유와 이미 정산이 끝난 과거 숫자를 일부러 고치지 않은 이유를 정리한 기록이다.
이 글의 코드·테이블·컬럼·API 이름은 개념 설명을 위해 단순화·일반화한 예시이며, 실제 코드가 아니다.
요약
증상: 월 통계와 일 통계(정산 근거)의 성공 건수가 다르다. 특정 고객사의 4월 기준 2,384건 차이
해결: 집계 기준 계층을 일원화하고, 반열린 구간으로 경계를 바꾸고, 배치의 트랜잭션·스케줄을 정리하고, 재집계 API를 만들었다
판단: 이미 정산이 끝난 4~6월 데이터는 일부러 고치지 않았다. 데이터의 절대적 정확성보다 확정된 회계 기록과의 일관성을 택했다
항목
내용
기간
2026.05 ~ 2026.08
역할
원인 분석 · 수정 · 검증 (백엔드), 정산 부서와 소급 범위 협의
기술
Java 11, Spring, MyBatis, MariaDB, ShedLock
키워드
데이터 정합성, 배치, 날짜 경계, 반열린 구간, 트랜잭션, 재집계
0. 먼저, 숫자가 흘러가는 길
담당 서비스의 이용 통계는 이력 원본에서 출발해 세 단계 테이블을 거치고, 두 곳으로 나간다.
이력 원본 ──► STAT_10MIN (10분 단위) ──► STAT_DAILY (일 단위) ──► STAT_MONTHLY (월 단위)
                                              │                        │
                                      정산 시스템의 근거 데이터     관리 화면의 월별 통계
                                                                    월간 리포트 메일
같은 기간의 숫자가 서로 다른 두 경로로 나가기 때문에, 어느 한쪽이 어긋나면 반드시 누군가는 그 차이를 발견하게 된다. 이 사건은 그렇게 발견됐다.
1. 증상
고객사가 관리 화면의 월별 통계(STAT_MONTHLY)에서 본 검증 성공 건수와, 정산에 쓰이는 STAT_DAILY의 건수가 다르다고 문의했다. 운영팀이 두 테이블을 직접 비교해 실제로 다르다는 것을 확인했고, 개발 쪽에 개선이 요청됐다.
2026년 4월 집계분부터 두 값이 어긋나기 시작했다
특정 고객사의 4월 성공 건수 차이는 2,384건이었다
우선순위가 높은 다른 작업에 밀려, 대응 개발은 6월 말에야 착수할 수 있었다
2. 원인을 좁힌 결정적 단서
어긋난 쪽은 STAT_MONTHLY였다. STAT_DAILY는 정산이 이미 기준으로 쓰고 있었고 문제가 없었다. 그런데 이상한 점이 하나 있었다.
이미 끝난 달(4월 등)은 어긋나는데, 아직 말일이 지나지 않은 6월은 일치했다.
차이가 나는 달과 나지 않는 달의 유일한 차이는 "말일이 지났는가"였다. 이 관찰 하나로 가설이 "말일 데이터가 월 집계에서 빠진다"로 좁혀졌다. 검증은 일 단위 합계와 월 단위 값을 고객사별로 대조하는 쿼리로 했다 (단순화한 예시).
SELECT d.CUSTOMER_ID, d.day_success, m.month_success,
       d.day_success - m.month_success AS success_diff
FROM (SELECT CUSTOMER_ID, SUM(SUCCESS_CNT) AS day_success
        FROM STAT_DAILY
       WHERE FROM_DATE BETWEEN '20260401' AND '20260430'
       GROUP BY CUSTOMER_ID) d
JOIN (SELECT CUSTOMER_ID, SUM(SUCCESS_CNT) AS month_success
        FROM STAT_MONTHLY
       WHERE FROM_DATE = '202604'
       GROUP BY CUSTOMER_ID) m USING (CUSTOMER_ID);
-- 대상 고객사 행에서 success_diff = 2384
3. 근본 원인 — 자릿수가 다른 문자열의 BETWEEN
STAT_MONTHLY를 만드는 집계 쿼리는 10분 단위 원본인 STAT_10MIN을 읽으면서 이런 조건을 쓰고 있었다.
FROM STAT_10MIN
WHERE FROM_DATE BETWEEN '20260401' AND '20260430'
문제는 두 값의 자릿수다. STAT_10MIN.FROM_DATE는 yyyyMMddHHmmss14자리인데 파라미터는 yyyyMMdd8자리로 들어간다. 문자열 비교에서는 앞 8자리가 같으면 자릿수가 긴 쪽이 더 크다.
'20260430000000' <= '20260430' → 거짓 (범위 밖)
말일 00:00:00 이후의 모든 행이 상한값보다 커지면서 말일 하루치가 통째로 빠졌다.BETWEEN이 상한을 포함한다는 사실은 자릿수가 다르면 아무 의미가 없었다.
그림 1. 4월 집계에서 4/30 전체가 상한값 비교에서 탈락한다.
STAT_DAILY는 일 단위(8자리)라 같은 문제가 생기지 않았고, 그래서 정산은 정상이었다. 불일치가 월 통계에서만 나타난 이유다.
4. 원인을 보다가 함께 발견한 것들
한 줄짜리 버그를 찾으러 들어갔지만, 주변 코드를 읽다 보니 같은 배치에 문제가 더 있었다.
일 배치와 월 배치가 같은 시각에 실행되어 같은 테이블을 두고 경합
월 집계가 STAT_DAILY가 아닌 STAT_10MIN을 참조 — 집계 기준 계층이 이원화
트랜잭션을 연 뒤 early return 경로에서 commit()/rollback()이 호출되지 않음
마지막 갱신 시각이 null인 초기 상태에서 NPE 가능
배치 소요 시간 로그가 없어 스케줄을 조정할 근거가 없음
5. 해결
구분
조치
집계 기준
월 집계의 참조 테이블을 STAT_10MIN → STAT_DAILY로 변경. 10MIN → DAILY → MONTHLY 단일 계층 확립
날짜 경계
BETWEEN → 반열린 구간(>= from AND < to). 애플리케이션의 상한 계산도 함께 바꿔 경계 정의를 일치
스케줄 분리
월 배치를 일 배치와 겹치지 않는 시각으로 이동, 종료 시점·소요 시간 로그 추가
트랜잭션 안정화
모든 early return 경로에 commit() 추가, null 분기 처리, 통계 타입을 enum으로 정리
재집계 API
기간을 지정해 delete → insert 하는 수동 재집계 API 신규 개발
핵심 변경 (단순화한 예시)
<!-- 참조 테이블 변경(STAT_10MIN → STAT_DAILY) + BETWEEN 대신 반열린 구간 -->
<insert id="insertMonthlyStat">
INSERT INTO STAT_MONTHLY (...)
SELECT #{fromDate}, {구분 키 컬럼들}, SERVICE_TYPE
, SUM(REQ_CNT), SUM(SUCCESS_CNT), SUM(INCOMPLETE_CNT), ...
FROM STAT_DAILY
WHERE FROM_DATE >= #{statFromDate} AND FROM_DATE < #{statToDate}
GROUP BY {구분 키 컬럼들}, SERVICE_TYPE
</insert>
// 상한은 "말일"이 아니라 "다음 달 1일(미포함)"로 정의한다
// 변경 전: month.atEndOfMonth()
LocalDate statToDate = month.plusMonths(1).atDay(1);

// 일 배치와 겹치지 않도록 실행 시각 분리 (시각·락 시간은 예시 값)
@Scheduled(cron = "0 30 1 * * *")
@SchedulerLock(name = "monthlyStatJob", lockAtMostFor = "PT10M")
protected void monthlyStatJob() {
    long start = System.currentTimeMillis();
    statService.runMonthly();
    log.info("monthly stat job end. elapsed={}ms", System.currentTimeMillis() - start);
}

// 트랜잭션 종료가 누락되던 경로 보완
if (firstTx == null) {
    log.debug("no data to aggregate");
    transactionManager.commit(transactionStatus);   // 추가
    return;
}
재집계 API에서 가장 신경 쓴 설계는 배치의 락·상태 테이블을 건드리지 않는 것이었다. 기존에는 과거 데이터를 다시 계산하려면 운영자가 상태 테이블의 마지막 갱신 시각을 직접 UPDATE해야 했다. 이 방식은 정기 배치의 진행 상태를 오염시키고 되돌리기도 어렵다. 새 API는 파라미터를 검증하고, 지정한 기간의 데이터만 delete → insert 하며, 실패하면 rollback 후 예외를 전파한다.
6. 기술적 의사결정
① @Transactional을 쓰지 않고 수동 트랜잭션을 유지했다. 가장 깔끔해 보이는 선택지였지만 적용하지 않았다.
기존 코드가 catch에서 예외를 삼키고 있어서, 프록시 기반 AOP는 이를 정상 종료로 보고 commit한다. 어노테이션만 붙이면 오히려 잘못된 데이터가 커밋될 수 있었다.
finally에서 예외 여부와 무관하게 상태를 갱신하는데, 같은 트랜잭션으로 묶이면 이 갱신까지 롤백된다. 분리하려면 구조를 크게 바꿔야 했다.
운영 배치의 리스크에 비해 변경 범위가 과하다고 판단해, 누락된 종료 경로만 명시적으로 보완하는 최소 침습 수정을 택했다.
② 월 집계의 기준을 STAT_10MIN이 아닌 STAT_DAILY로 정했다. "가장 상세한 원본에서 매번 재계산한다"는 원래 설계 의도도 이해는 됐다. 하지만 정산이 이미 STAT_DAILY를 신뢰의 기준으로 쓰고 있었다. 집계 기준을 하나로 통일하는 것이 정밀도보다 우선이라고 판단했다. 서로 다른 소스에서 계산된 두 숫자는 언제든 다시 어긋날 수 있기 때문이다.
③ 과거 데이터를 소급 재계산하지 않기로 했다. 기술적으로는 4~6월 전체를 다시 집계할 수 있었다. 그러나 그 기간은 정산이 이미 끝난 구간이었다. 정산 부서와 협의해 범위를 나눴다.
4~6월: 기존(버그 포함) 데이터를 유지 — 정산 정합성 우선
7월 이후: 패치 버전 기준으로 통계·정산 진행
데이터의 절대적 정확성보다 이미 확정된 회계 기록과의 일관성을 택한 트레이드오프다. 대신 기준일을 명확히 공유해서 이후 데이터는 정확하도록 했다.
④ 발견했지만 바로 고치지 않은 것 — INCOMPLETE_CNT. 집계 쿼리를 분석하다가 INCOMPLETE_CNT가 이름과 달리 결과 코드 조건 없이 전체 요청 건수처럼 집계되고 있음을 발견했다. 그런데 이 값은 월간 사용현황 메일에 그대로 노출되고 있었다. 코드를 먼저 고치면 대외 보고 숫자가 바뀐다. 업무 정의 확인을 선행 과제로 분리하고 별도 커밋으로 미뤘다. (이 컬럼은 몇 달 뒤 월간 리포트 이슈에서 다시 등장한다.)
⑤ 커밋을 성격별로 나눴다. 문제가 생겼을 때 되돌릴 범위를 좁히기 위해서다.
커밋 1: 일별/월별 집계 기준 및 날짜 경계 수정
커밋 2: 트랜잭션 / null / 파싱 안정성 수정
커밋 3: 10분 통계 중복 insert 방지
커밋 4: INCOMPLETE_CNT 업무 정의 반영
7. 테스트 코드가 없는 환경에서 어떻게 검증했나
프로젝트에 테스트 코드가 없었다. 그래서 SQL 결과를 직접 대조하는 방식으로 검증을 설계했다.
_TEMP 테이블에서 기존 쿼리 vs 신규 쿼리의 결과를 만든다
10MIN → DAILY → MONTHLY 3계층을 각각 합산해 세 값이 일치하는지 본다
로컬 → 개발 서버 호출 → 스테이징 배포 후 담당자 검증 → 운영 반영 순으로 단계적으로 넓힌다
운영 반영 뒤 같은 대조를 다시 수행하고 증적을 문서로 남긴다
8. 결과
특정 고객사 4월 기준 STAT_DAILY ↔ STAT_MONTHLY 성공 건수 차이 2,384건 → 0건
날짜 경계를 반열린 구간으로 통일해 자릿수 불일치로 누락되는 구조 자체를 제거
트랜잭션 미종료 경로와 NPE 지점 제거, 배치 스케줄 충돌 해소, 소요 시간 로그로 이후 스케줄 조정의 근거 확보
재집계 API와 인수인계 가이드를 제공해 상태 테이블을 직접 수정하던 보정 작업을 API 호출 한 번으로 대체
9. 이 사건에서 얻은 것
문자열은 비교되는 순간 의미가 정해진다. 같은 "날짜"라도 자릿수가 다르면 BETWEEN은 다른 뜻이 된다. 경계는 포함/미포함이 명확한 반열린 구간으로 정의한다.
숫자를 만드는 경로는 하나여야 한다. 서로 다른 소스에서 계산된 두 숫자는 언제든 다시 어긋난다.
고칠 수 있는 것과 고쳐도 되는 것은 다르다. 과거 정산 데이터, 대외 보고 숫자처럼 기술적으로는 고칠 수 있지만 조직이 감당할 수 없는 수정은 범위에서 분리했다.
그런데 이 사건이 정리된 뒤, 이번에는 월간 리포트에서 약 277만 건이 0으로 표시되는 더 이상한 문제가 접수됐다. 원인은 단 2건의 대소문자 다른 데이터였다. 다음 글에서 이어진다.
iOS에서만 CAPTCHA 숫자가 항상 고정 숫자로 고정되고, 새로고침도 먹통이 되는 버그를 만났다. 그런데 정작 서버에도 프론트에도 실패했다는 로그가 단 한 줄도 없었다. 이 글은 "어디서 왜 실패하는지 아무도 모르는" 상태를, 버그를 고치기 전에 관측 가능한 상태로 먼저 바꾸고, 그렇게 확보한 로그로 실제 근본 원인까지 규명한 과정을 정리한 기록이다.
TL;DR
증상: 담당 서비스의 인증 팝업에서 CAPTCHA 보안문자가 항상 고정 숫자로만 노출되고, 새로고침 버튼이 동작하지 않는 것처럼 보임
함정: 사용자가 화면에 보이는 고정 숫자를 입력하면 "인증번호 불일치"가 뜬다 → 그런데 어디서도 실패 로그가 안 남는다
판단: 원인 후보가 5개 이상이고 재현도 안 되는 상황에서 추측으로 코드부터 고치지 않았다. 대신 실패 지점 8곳에 구조화 로그를 심어 "관측 가능한 문제"로 먼저 전환했다 (Phase 1)
결말: 확보한 운영 로그를 근거로, "iOS 단말 문제"로 여겨지던 이 이슈가 사실은 프론트 HTML에 하드코딩된 정적 더미 이미지가 요청 실패 시 그대로 노출되는 구조적 결함이라는 것을 규명했다 (Phase 2). 1년 가까이 원인 미상으로 남아있던 이슈였다.
1. 문제 발견
담당 서비스의 인증 팝업(웹뷰 기반 인증 페이지)에서 CAPTCHA 입력 단계 불만이 CS로 들어오기 시작했다. 증상을 재정리하면 이랬다.
iOS 환경에서 진행 시 CAPTCHA 보안문자 이미지가 항상 고정 숫자로만 보인다
새로고침 버튼을 눌러도 다른 숫자로 바뀌지 않는다 (동작하지 않는 것처럼 보임)
화면에 보이는 고정 숫자를 그대로 입력하면 "인증번호가 일치하지 않습니다" 메시지가 뜨고 인증이 끝나지 않는다
심지어 기기를 재부팅하거나 앱을 재설치해도 동일한 증상이 반복된다는 CS도 있었다
숫자가 "고정"되어 보인다는 것부터가 이상했다. CAPTCHA는 매 요청마다 서버가 새로 발급해서 Redis에 저장하는 구조였기 때문에, 정상적으로 동작한다면 같은 값이 반복해서 뜰 이유가 없었다.
원인 후보를 팀 논의에서 여러 개 올렸다.
프론트 캐싱 문제 (이미지가 캐시되어 안 바뀌는 것 아닌가)
랜덤 시드 문제 (서버 쪽 난수 생성이 고장난 것 아닌가)
세션/쿠키 문제 (iOS WebView의 쿠키 정책 때문 아닌가)
레이스 컨디션 (요청이 겹쳐서 이전 값이 남는 것 아닌가)
네트워크/WebView 자체 문제 (iOS 인앱 브라우저 특유의 제약 아닌가)
이 시점에서 나온 후보만 5개. 그런데 이걸 하나씩 검증할 방법이 없었다.
2. 재현 시도가 막힌 이유
가장 먼저 한 일은 당연히 재현이었다. 그런데 스테이징에서도, 로컬에서도 이 증상이 재현되지 않았다. iOS 특정 버전 + 특정 인앱 브라우저(네이버 앱 등) 조합에서만 산발적으로 발생하는 것으로 추정됐는데, 사내에서 그 조합의 실 기기를 확보하기도 어려웠고, 확보해도 실패가 매번 재현되는 게 아니었다.
더 큰 문제는 따로 있었다. 서버에도 프론트에도 이 흐름에 대한 실패 로그가 단 한 줄도 없었다. 서비스운영파트에 문의해도 "그냥 새로고침이 안 된다"는 사용자 진술 이상의 정보가 없었다. 즉:
네트워크 / 서버 응답 / Blob 변환 / 이미지 반영 중 어느 단계에서 실패했는지 알 수 없었다
왜 iOS에서만 발생하는지 알 수 없었다
애초에 요청이 서버까지 도달은 했는지조차 알 수 없었다
재현도 안 되고, 로그도 없고, 원인 후보는 5개. 여기서 흔히 하는 실수가 "그럴듯한 후보 하나를 골라서 고치고 배포해보는 것"이다. 나는 그렇게 하지 않기로 했다.
3. 원인 후보 배제 과정
먼저 CAPTCHA 이미지가 어떻게 화면에 뜨는지부터 코드를 역추적했다. 구조는 이랬다.
인증창 HTML은 <img> 태그의 초기값으로 디자인용 플레이스홀더 이미지를 넣어둔다
페이지 로드 시 /gui/popup/captcha/image 로 요청을 보내고, 성공하면 응답으로 받은 이미지로 <img> 의 src를 교체한다
여기까지 보고 나서 의심 후보 중 "캐싱", "레이스 컨디션" 두 개는 코드상 자연스럽게 배제됐다 — 애초에 캐시 제어 헤더나 동시 요청을 막는 로직 자체가 없어서, 캐싱/레이스 컨디션이 원인이라면 오히려 더 다양한 값이 보였어야 했다.
그리고 진짜 문제를 찾았다. 이미지 교체 로직 자체에 실패를 감지하는 코드가 없었다.
// 문제 코드: process.js
requestImage: function (url, data, element) {
    var request = new XMLHttpRequest();
    request.open("POST", url, true);
    request.responseType = "blob";

    request.onload = function () {          // HTTP 상태 코드 미검사
        var reader = new FileReader();
        reader.onloadend = function () {     // onerror 미정의
            element.src = reader.result;
        }
        reader.readAsDataURL(this.response);
    }
    // onerror / onabort / ontimeout 전부 없음
    request.send(JSON.stringify(data))
}
이 함수에는 다음이 전부 빠져 있었다.
HTTP 상태 코드 확인 (onload는 4xx/5xx가 와도 그냥 실행된다)
onerror, onabort, ontimeout 핸들러
응답 MIME 타입·크기 검증
실패 시 UI 표시나 재시도 로직
중복 요청/응답 순서 제어
즉, iOS에서 XHR이 실패하거나 중단되면 아무 표시도 없이 초기 플레이스홀더 이미지가 그대로 남는 구조였다. 새로고침 버튼도 같은 요청을 다시 보내고 똑같이 실패를 무시하니 "버튼이 안 먹는다"처럼 보인 것도 자연스럽게 설명됐다. 그리고 서버는 실제 정답을 Redis에 별도로 저장해두는 구조였으니, 사용자가 화면의 고정 숫자를 입력하면 당연히 "불일치"가 날 수밖에 없었다. 버그가 아니라 버그의 증상만 보고 있었던 것.
여기까지 오면 "그럼 이 코드만 고치면 되는 거 아니야?" 라는 생각이 들 수 있다. 실제로 나도 그랬다. 하지만 한 가지가 걸렸다.
왜 iOS에서만 XHR이 실패하는지는 여전히 알 수 없었다. 코드를 고쳐도, 그게 "진짜 원인"을 없앤 건지 "증상 하나"만 가린 건지 검증할 방법이 없었다.
4. Phase 1 — "고치기" 전에 "보이게 하기"
이게 이 이슈에서 가장 중요한 판단이었다고 생각한다. 원인 후보가 여러 개고 재현도 안 되는 상태에서 코드를 추측성으로 고치면, 고쳐졌는지조차 확인할 수 없다. 그래서 운영팀에는 이렇게 명확히 전달했다.
현재 소스 코드 상 해당 과정에서 에러 내용과 원인을 기록하는 로직이 없어, 과거 사례의 구체적인 실패 원인과 iOS에서만 발생한 이유는 현시점에서 확인하기 어렵습니다. 따라서 현재 할 수 있는 것은 구체적인 에러 내용과 원인을 알 수 있는 로직을 추가하여 배포하는 것입니다.
그래서 대응을 2단계(Phase)로 나눴다.
Phase
목표
상태
Phase 1
실패 지점별 진단 로그 확보 (관측 가능성 확보)
완료
Phase 2
확보한 로그 분석 → 원인 확정 → 대응 개발
원인 확정 완료, 코드 수정은 CS 재인입 시 진행
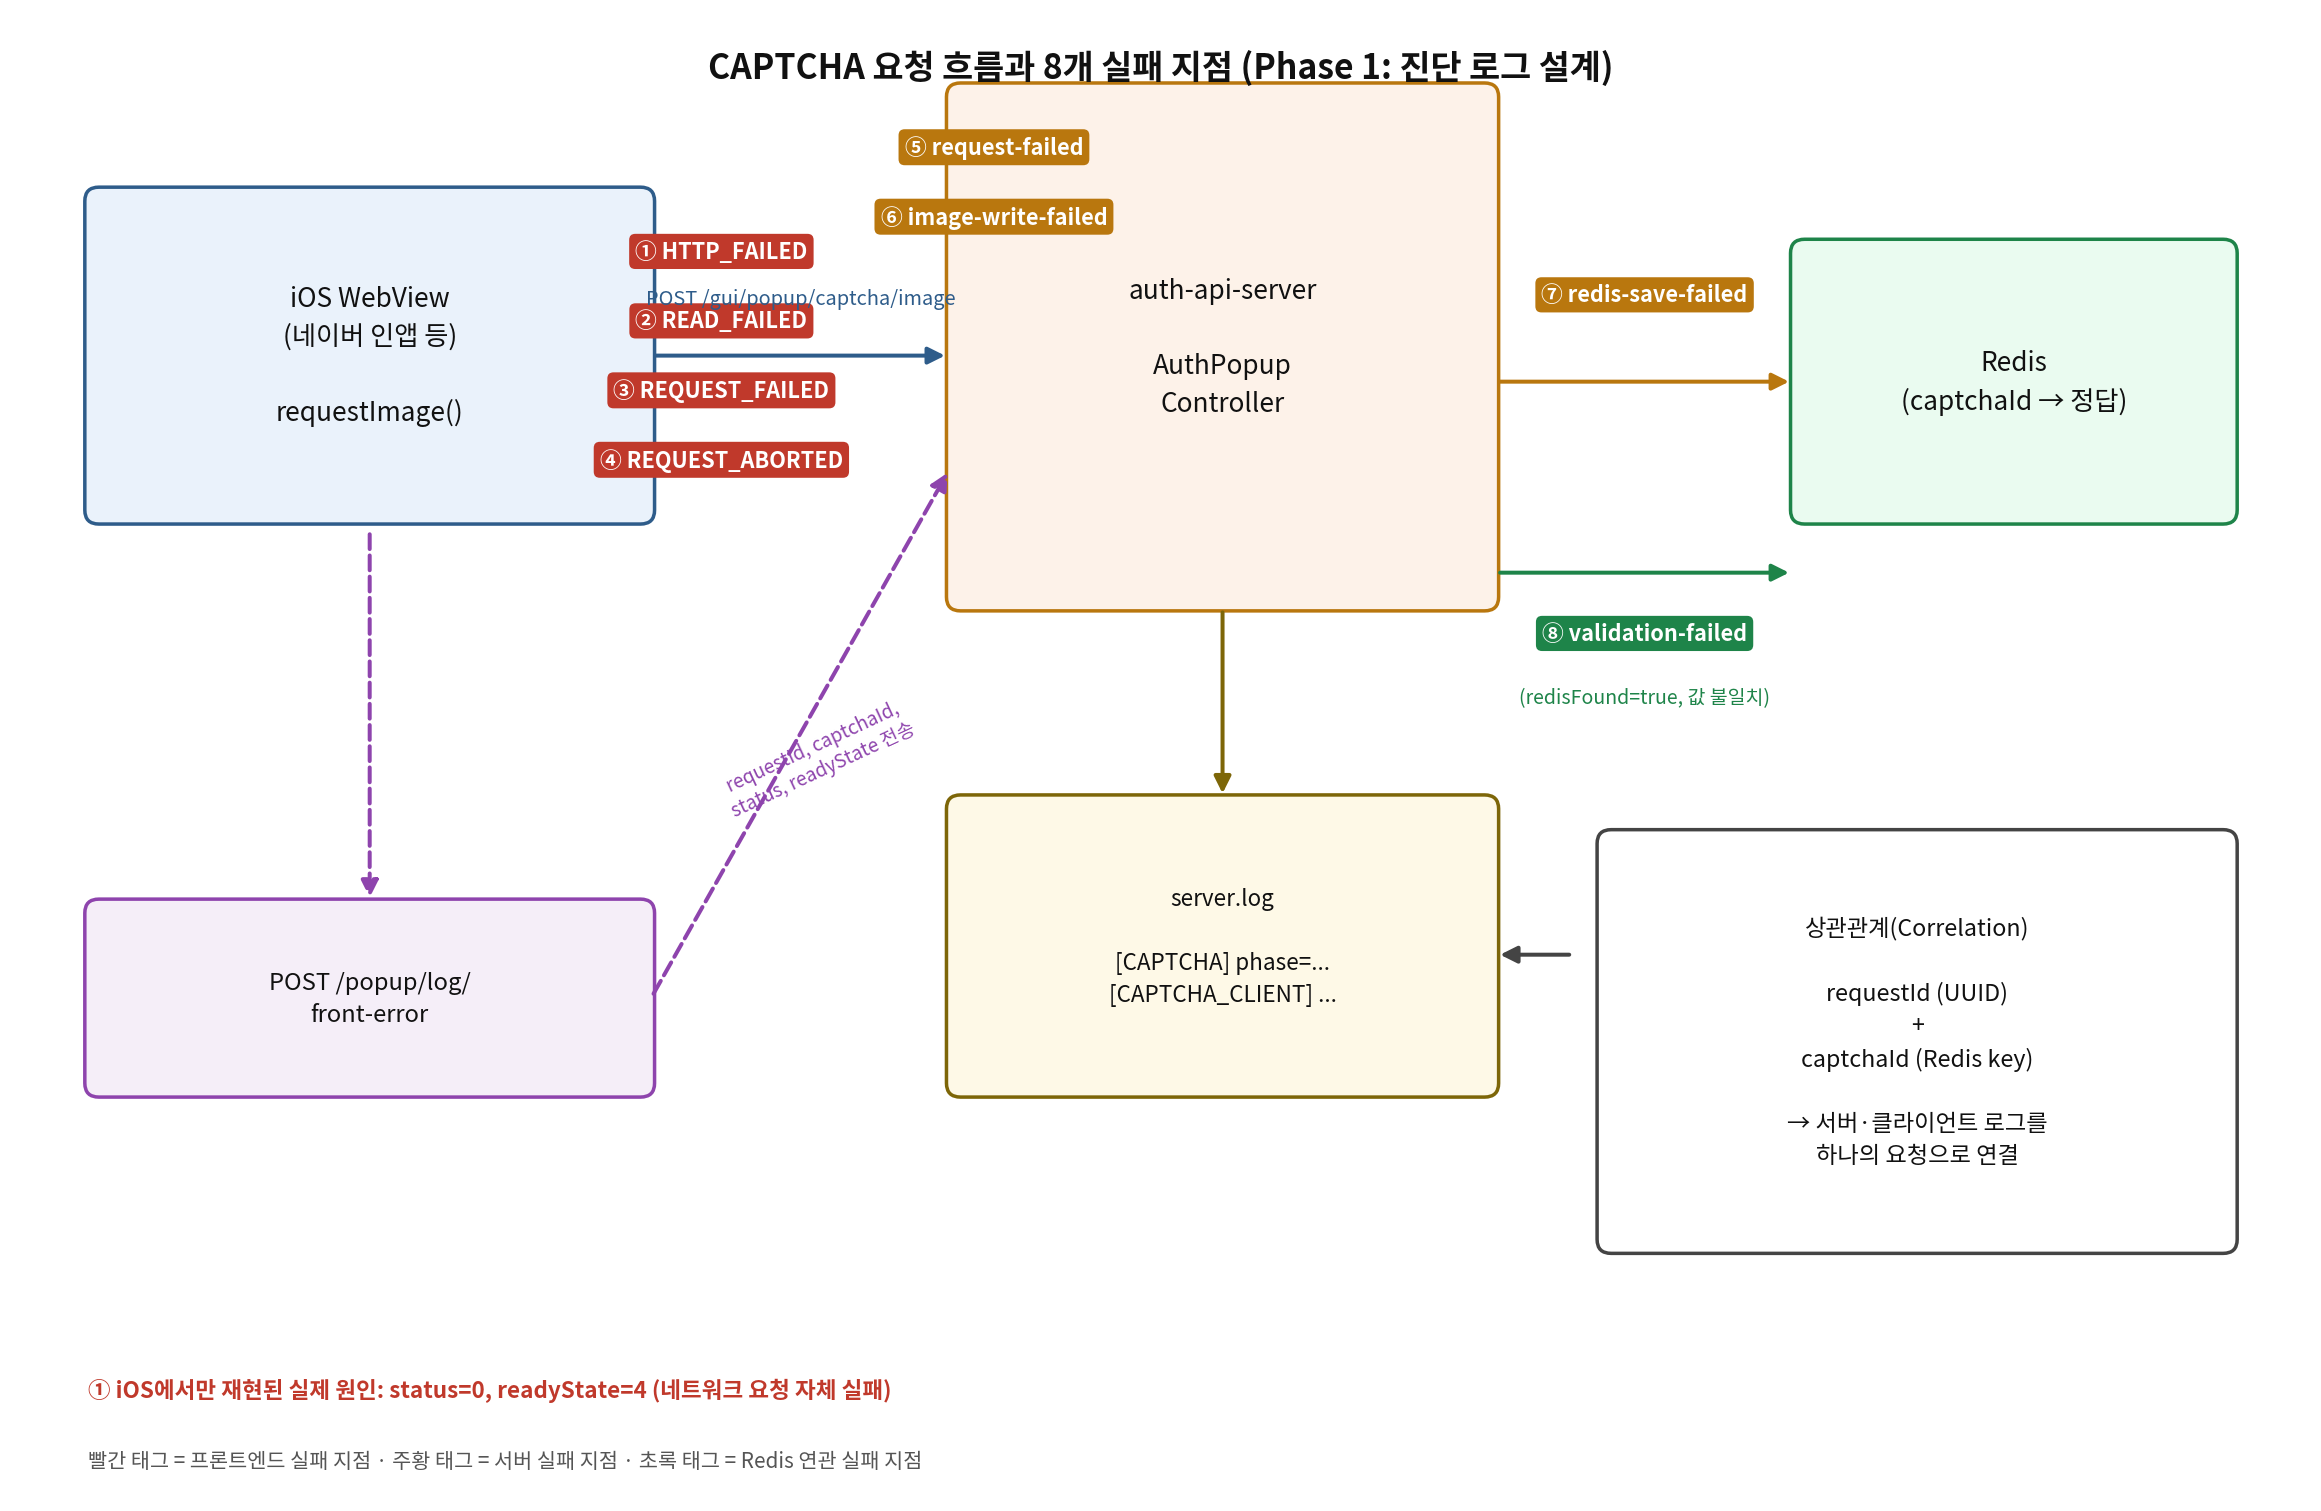
CAPTCHA 처리 흐름을 다시 그려보면 실패가 날 수 있는 지점이 서버 4곳, 프론트 4곳, 총 8곳이었다.
그림 1. iOS WebView → auth-api-server → Redis 로 이어지는 요청 흐름에서 실패가 발생할 수 있는 8개 지점. Phase 1은 이 8곳 각각에 구조화 로그를 심는 작업이었다.
4-1. 백엔드 — 서버 쪽 4개 실패 지점
공통 접두어 [CAPTCHA] 와 phase= 키를 쓰는 구조화 로그 포맷을 정했다.
phase=request-failed       # 요청 처리 실패 (예외 종류, 응답 커밋 여부, 소요 시간)
phase=image-write-failed   # 응답 스트림 이미지 쓰기 실패 (Broken pipe 등)
phase=redis-save-failed    # 생성한 정답의 Redis 저장 실패
phase=validation-failed    # 입력값 검증 실패 (Redis 조회 성공 여부 포함)
까다로웠던 건 image-write-failed 쪽이었다. 응답 스트림에 이미지를 쓰다가 나는 IOException (클라이언트가 연결을 끊는 등)은 일반적인 컨트롤러 레벨 try-catch로는 잡히지 않는다. 그래서 ServletOutputStream을 위임(delegate) 패턴으로 감싸서, 실제 write() 호출 시점의 예외를 가로채는 래퍼(CaptchaResponseTracker)를 만들었다.
// 응답 스트림에 실제로 쓰는 시점의 실패를 잡는 래퍼
@Override
public void write(byte[] value, int offset, int length) throws IOException {
    try {
        delegate.write(value, offset, length);
    } catch (IOException exception) {
        tracker.recordWriteFailure(exception);
        throw exception;
    }
}
4-2. 프론트 — 클라이언트 쪽 4개 실패 지점
requestImage()에 상태 코드 검사와 실패 핸들러를 추가하고, 실패 유형을 4가지 에러 코드로 분류했다.
CAPTCHA_IMAGE_HTTP_FAILED       # 404, 500, 502, 503 등 HTTP 응답 오류
CAPTCHA_IMAGE_READ_FAILED       # 응답은 받았으나 FileReader가 Blob 읽기 실패
CAPTCHA_IMAGE_REQUEST_FAILED    # 서버 연결 불가, DNS/CORS/TLS/네트워크 단절
CAPTCHA_IMAGE_REQUEST_ABORTED   # 페이지 이동, 인증창 종료, abort() 호출
4-3. 클라이언트 로그를 서버로 끌어오기
브라우저에서 난 실패는 당연히 서버 로그에 안 남는다. 그래서 클라이언트 오류를 서버 로그로 전달하는 엔드포인트를 하나 신설했다.
전송하는 값은 requestId, captchaId, HTTP status, readyState, User-Agent 정도로 한정했다. CAPTCHA 정답이나 사용자가 입력한 값은 절대 로그에 남기지 않았고, 서버에 기록할 때도 MaskingUtil로 마스킹을 거치게 했다. 담당 서비스 특성상 로그 자체가 또 다른 위험이 될 수 있어서다.
4-4. 서버 로그와 클라이언트 로그를 하나로 연결하기 (Correlation)
서버가 요청마다 발급하는 requestId(UUID)와, Redis 키로 쓰이는 captchaId를 클라이언트 로그에도 그대로 실어 보내게 했다. 이렇게 하면 "브라우저에서 시작된 실패"를 서버 로그 한 곳에서 requestId 하나로 추적할 수 있다.
실제로 스테이징 배포 후 운영 로그에서 잡힌 실패 사례는 이런 모습이었다 (아래 IP는 예시로 대체함).
# 이미지 요청 자체가 실패한 케이스 검색
grep -i "CAPTCHA" /app/wildfly/wildfly/domain/servers/auth-was0*/log/server.log* \
  | grep "phase=image-request-failed"

# 결과 예시
[CAPTCHA_CLIENT] clientIp=203.0.113.10 payload={
  "errorCode":"CAPTCHA_IMAGE_REQUEST_FAILED",
  "pageUrl":"https://cert.example-auth.com/auth_popup.html",
  "userAgent":"Mozilla/5.0 (iPhone; CPU iPhone OS 26_6 like Mac OS X) ... NAVER(inapp; search; ...)",
  "message":"[CAPTCHA] phase=image-request-failed requestId=38da7f64-... requestUri=/gui/popup/captcha/image status=0 readyState=4",
  "timestamp":"2026-08-17T06:06:08.093Z"
}
status=0, readyState=4 조합은 브라우저가 서버에 요청을 아예 보내지 못했거나 응답을 못 받았을 때 나오는 전형적인 패턴이다. User-Agent에 찍힌 NAVER(inapp; ...) 문자열까지 더해서, "iOS 인앱 WebView 환경에서 네트워크 요청 자체가 실패한다" 는 가설이 처음으로 데이터로 뒷받침되는 순간이었다.
5. 재현이 안 되는 버그, 어떻게 테스트했나
Phase 1 개발 자체를 검증하는 것도 문제였다. 8개 실패 지점을 "일부러" 발생시켜서 로그가 제대로 찍히는지 봐야 했는데, 운영 코드는 건드리지 않는다는 제약이 있었다. 실패 유형별로 재현 방법을 다르게 설계했다.
실패 유형
재현 방법
request-failed
Postman으로 형식이 깨진 토큰(not-json) 전송
validation-failed
인증 요청을 cURL로 복사해 재전송 (CAPTCHA는 1회 검증 후 Redis에서 삭제되는 점을 이용)
DevTools Snippets에서 FileReader를 일시적으로 가로채 NotReadableError 강제 발생
image-request-aborted
숨긴 iframe에서 네이티브 XMLHttpRequest를 확보해 send() 직후 abort() 호출
redis-save-failed
스테이징·운영에서 재현 불가 → 단위 테스트 코드로 검증
image-request-aborted 케이스가 특히 까다로웠다. 페이지에 이미 프록시로 감싸둔 XMLHttpRequest가 있어서, 그걸 그대로 쓰면 로그 전송용 요청까지 같이 오염됐다. 그래서 숨긴 iframe의 contentWindow에서 원본(프록시 안 걸린) XMLHttpRequest를 꺼내 쓰는 방식으로 우회했다.
6. Phase 2 — 근본 원인 확정
Phase 1에서 로그를 심어두고 몇 주간 운영 로그를 쌓은 뒤, 이 데이터를 근거로 Phase 2(원인 분석)를 진행했다.
확정된 근본 원인
프론트 저장소 코드를 다시 훑다가 결정적인 단서를 찾았다. 인증 팝업 HTML의 CAPTCHA <img> 태그 초기 src가 정적 파일(더미 이미지)로 하드코딩되어 있었고, 그 파일을 직접 열어보니 표기값이 화면에서 보던 고정 숫자와 정확히 일치했다.
즉, 사용자가 보던 그 숫자는 서버가 생성한 CAPTCHA 정답이 아니라, 퍼블리싱 단계에서 넣어둔 더미 이미지였다. 이 더미 이미지는 페이지가 로드되는 순간부터 모든 사용자에게 노출되고, 정상적인 경우엔 XHR 응답으로 곧바로 교체되어 아무도 보지 못한다. 문제는 그 요청이 끝까지 도달하지 못하면 더미 이미지가 그대로 화면에 남는다는 것이었다.
새로고침·재부팅·재설치로 해결되지 않는 이유
로그와 코드를 같이 보니 CS에서 반복되던 세 가지 진술이 전부 코드로 설명됐다.
"새로고침을 눌러도 그대로예요" — 새로고침 버튼은 페이지를 다시 불러오는 게 아니라, 동일한 이미지 요청 함수를 한 번 더 호출할 뿐이었다. 요청이 실패하는 조건 자체가 없어지지 않으면 결과도 똑같았다.
"버튼을 눌러도 화면이 안 바뀌어요" — requestImage()의 모든 실패 경로(onerror, onabort, reader 실패)는 로그만 남기고 element.src를 전혀 건드리지 않는다. 사용자 입장에선 버튼이 반응이 없는 것처럼 보일 수밖에 없었다.
"재부팅·재설치해도 똑같아요" — 더미 이미지는 단말기 캐시가 아니라 서버가 내려주는 HTML 안에 정적 리소스로 포함되어 있었다. 기기를 초기화해도 페이지 자체가 항상 그 이미지로 시작하니 증상이 반복될 수밖에 없었다.
Phase 1에서 확보해둔 validation-failed (redisFound=true) 로그의 의미도 이 시점에 완전히 확정됐다. Redis에는 진짜 정답이 정상적으로 저장돼 있고, 사용자는 화면의 더미 값을 입력하니 값만 불일치하는 것이었다.
여기에 더해, requestImage()의 HTTP 오류 처리 코드에 return문이 빠져 있어서 503/504 같은 오류 응답을 받고도 그 오류 응답 본문을 그대로 이미지로 설정하려 시도하는 추가 결함도 발견했다.
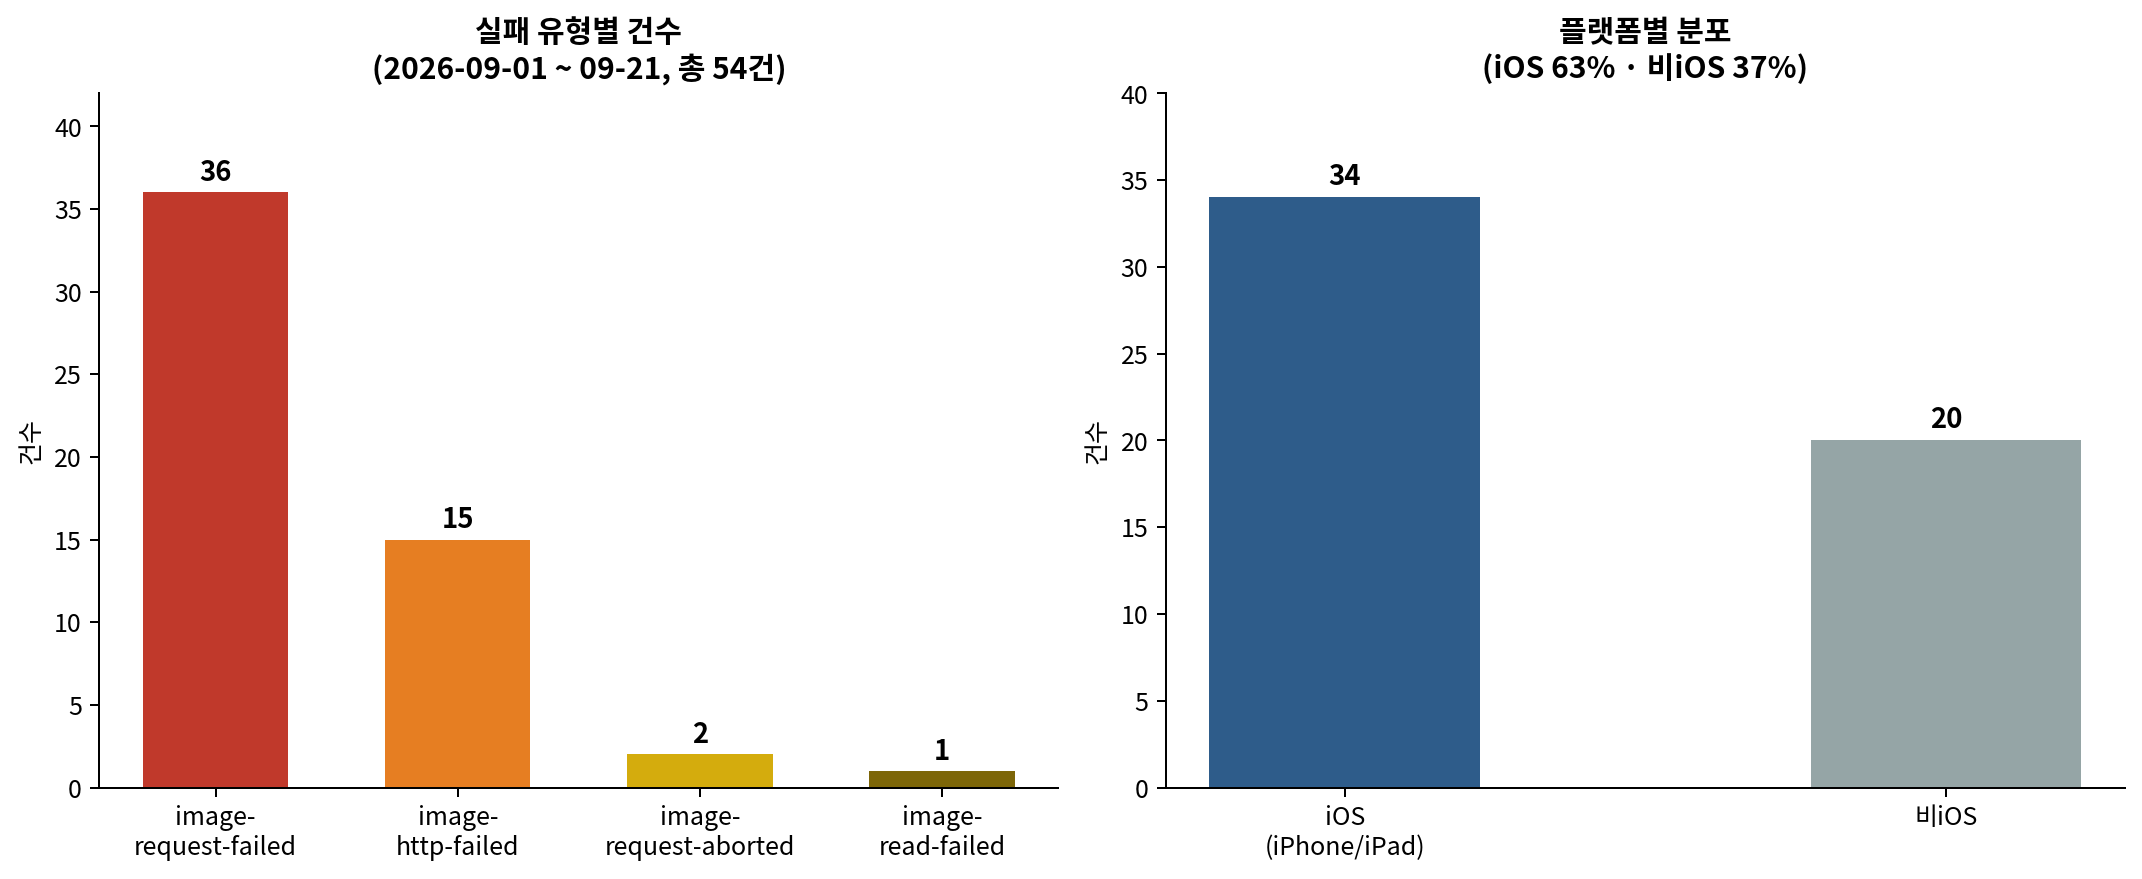
운영 로그로 본 실제 분포
3주간(2026-09-01 ~ 09-21) 누적된 클라이언트 실패 로그를 집계해봤다.
구분
건수
전체 오류
54
iOS (iPhone/iPad)
34 (63%)
비iOS
20 (37%)
image-request-failed
36
image-http-failed
15
image-request-aborted
2
image-read-failed
1
가장 흥미로웠던 지점은 비iOS 비중이 37%나 된다는 것이었다. 그동안 "iOS에서만 발생하는 문제"로 인식돼 왔는데, 실제로는 iOS 인앱 WebView(네이버 인앱, 카카오톡 인앱 브라우저 등)가 화면 전환이나 백그라운드 진입 시 진행 중인 XHR을 더 자주 끊어버리는 환경적 특성 때문에 노출 빈도가 높았던 것뿐이었다. 결함 자체는 플랫폼을 가리지 않는 구조적 문제였다.
또 하나 눈에 띈 건 clientIp가 단 두 개의 값으로만 집계된다는 점이었다. 확인해보니 이건 사용자의 실제 IP가 아니라 WAS 앞단 프록시/L4 장비의 IP가 찍히고 있었던 것이었다. 사용자 식별에는 쓸 수 없는 값이라, 이건 X-Forwarded-For 헤더 미반영이라는 별도 개선 과제로 분리했다.
Phase 1 설계 단계에서는 "이론상 있을 수 있는 실패"로만 분류해뒀던 image-read-failed도 실제로 1건 관측됐다. 설계할 때는 확신이 없던 실패 경로가 데이터로 증명되는 순간이었다.
대응 방향 — 최소 변경 원칙
원인이 명확해진 만큼, 변경 범위가 가장 작은 안부터 정리했다.
즉시 적용 가능 (변경량 3줄 수준, 서버·API 변경 없음)
더미 이미지 src를 제거하고, 로드 실패 시 "보안문자를 불러오지 못했습니다. 새로고침을 눌러주세요" 안내 문구를 노출
requestImage()의 HTTP 오류 처리부에 누락된 return 추가
이 두 가지만 반영해도 "틀린 값을 입력해서 인증이 막히는" CS는 원천 차단된다. 증상도 "인증 실패"에서 "보안문자 미표시"로 바뀌어서, 앞으로 비슷한 문제가 생겨도 원인 추적이 훨씬 쉬워진다.
추가 검토 항목
화면이 포그라운드로 돌아올 때 이미지 재요청 (visibilitychange 이벤트) — 변경량 대비 효과가 가장 클 것으로 예상
XHR 타임아웃 설정 (504 상황에서 무한 대기 방지)
새로고침 시 인증 토큰 자체를 갱신하는 방식 검토 (인증 플로우 전반에 영향이 있어 별도 검토 필요)
FileReader + readAsDataURL 대신 createObjectURL 또는 base64 JSON 응답으로 전환, 동기 XHR 제거, 자동 재시도 도입
병행 과제
서버 측 503/504 발생 원인 확인 (게이트웨이 타임아웃, 이미지 생성 소요 시간)
서버 로그에 User-Agent·clientIp(정확한 값) 추가
배포 시 프론트 난독화 재빌드 필요 여부 확인
의사결정
실제 코드 수정은 CS가 다시 재인입되는 시점에 진행하기로 팀과 합의했다. 원인이 확정되고 최소 변경 대응안까지 나온 상태에서, 발생 빈도(3주간 54건, 그마저도 대부분 실제 서비스 장애로는 이어지지 않는 수준)와 회귀 위험을 함께 고려한 결정이었다. 문제를 이해하지 못해서 미루는 것과, 문제를 완전히 이해한 상태에서 우선순위를 조정하는 것은 전혀 다른 이야기라고 생각한다.
7. 기술적 의사결정에서 신경 쓴 것들
돌아보면 로그 몇 줄 추가하는 작업처럼 보이지만, 판단이 필요한 지점이 꽤 많았다.
① "고치기"보다 "보이게 하기"를 먼저 선택했다. 원인 후보가 5개 이상이고 재현이 안 되는 상태에서 추측 수정은 검증 불가능한 수정이다. 관측 가능성 확보를 선행 과제로 명확히 분리해서 팀에 설명했다.
② 로깅 API에 기존 Command/Factory 계층을 태우지 않았다. 이 프로젝트는 요청마다 Command → Factory를 거치는 구조였지만, 단순 로그 수집에 같은 계층을 씌우는 건 오버엔지니어링이라고 판단했다. 새 컨트롤러 대신 기존 AuthPopupController에 메서드 1개만 추가해서 변경 범위를 최소화했고, 같은 presentation 패키지에 둬서 기존 ApiExceptionHandler의 예외 처리를 그대로 물려받는 이점도 챙겼다.
③ 전역 window.onerror 훅은 도입하지 않았다. 전역 훅을 걸면 CAPTCHA와 무관한 오류까지 서버로 들어와서 신호 대 잡음비가 나빠진다. 명시적으로 식별한 실패 지점에서만 리포트하도록 범위를 제한했다.
④ 보안을 우선했다. 담당 서비스라 로그 자체가 위험이 될 수 있다. 진단에 필요한 최소 정보(requestId, captchaId, 상태 코드, readyState, User-Agent)만 보내고, CAPTCHA 정답·사용자 입력값은 절대 로그에 남기지 않았다.
⑤ 성공 로그는 2차 배포에서 뺐다. 처음엔 request-start, image-generated 같은 성공 경로 로그도 넣었는데, 트래픽이 큰 인증 서비스에서 전 요청을 로깅하면 로그량·성능 부담이 커진다고 판단해서 실패 로그만 남기도록 축소했다.
⑥ 로그를 "찾을 수 있게" 설계했다. 로그를 남기는 것과 운영팀이 실제로 찾을 수 있는 것은 다른 문제다. 모든 로그에 [CAPTCHA] 접두어와 phase= 키를 통일해서 grep 한 줄로 검색 가능하게 했고, 검색 키워드와 로그 경로를 별도 문서로 정리해서 전달했다.
근본 원인 확정: Phase 1에서 구축한 로그를 근거로, 1년 가까이 재현 불가로 미해결이던 이슈의 원인이 프론트 HTML에 하드코딩된 정적 더미 이미지임을 규명했다. "iOS 단말 문제"로 여겨지던 장애를 플랫폼 공통의 구조적 결함으로 재정의하고, 최소 변경 대응안까지 도출했다.
관측 불가 영역 해소: 실패 기록이 전무했던 CAPTCHA 처리 흐름에 서버 4종 + 클라이언트 4종, 총 8개 실패 지점의 진단 로그를 확보했다. "로그 없이 추정만 반복"하던 상태를 데이터 기반으로 분석 가능한 상태로 바꿨다.
실제 원인 단서 포착: 운영 로그에서 실제 실패 사례가 잡혔다.
image-request-failed — iOS 인앱 WebView에서 status=0, readyState=4로 네트워크 요청 자체가 실패
image-request-aborted — 요청 중단 사례
validation-failed (redisFound=true) — Redis 조회는 성공했지만 값이 불일치한 케이스
request-failed — 요청 처리 단계 예외
재현 불가 이슈의 테스트 절차 확립: 운영 코드 무수정 원칙 하에 6가지 실패 시나리오의 재현 방법을 정립하고 문서화했다.
서버-클라이언트 로그 상관관계 확보: requestId / captchaId 기반으로, 브라우저에서 시작된 실패를 서버 로그 한 곳에서 추적할 수 있게 됐다.
협업: 서비스운영파트·개발파트와 2단계 대응 계획을 합의하고, 스테이징 배포 요청부터 테스트, 로그 가이드 전달까지 주도했다.
9. 회고
이 이슈를 하면서 가장 크게 느낀 건, "버그를 고치는 능력"과 "고칠 수 있는 상태로 만드는 능력"은 다른 능력이라는 점이었다. 원인 후보가 여러 개고 재현조차 안 되는 상황에서는, 아무리 실력이 좋아도 "감"으로 고치는 수밖에 없다. 그 상태에서 한 발 물러나 "지금 우리에게 정말 필요한 건 수정이 아니라 관측이다"라고 팀에 설명하고 합의를 끌어낸 과정 자체가, 코드 몇 줄 짜는 것보다 오히려 더 어려운 일이었다.
그리고 실제로 Phase 2에서 확인했듯, 관측이 먼저였기 때문에 원인을 "감"이 아니라 데이터로 확정할 수 있었다. "iOS에서만 생기는 문제"라는 처음의 전제 자체가, 운영 로그를 쌓고 나서야 "노출 빈도가 높았을 뿐인 플랫폼 공통 결함"으로 뒤집혔다. 만약 Phase 1을 건너뛰고 "iOS WebView 이슈니까 iOS 쪽만 방어 코드를 넣자"는 식으로 대응했다면, 비iOS에서도 반복되는 37%의 사례는 여전히 미해결로 남았을 것이다. 첫 가설을 의심하지 않고 그대로 밀어붙였다면 얻지 못했을 결론이었다.
또 하나는 "무엇을 로그로 남길지"를 정하는 것도 결국 설계라는 점이다. 너무 적게 남기면 여전히 못 찾고, 너무 많이 남기면 성능·보안·검색성이 다 나빠진다. 로그 설계도 API 설계나 스키마 설계처럼 트레이드오프를 저울질하는 작업이라는 걸 이번에 제대로 체감했다.
마지막으로, 원인을 다 알아낸 뒤에도 "지금 바로 고칠지, 다음 CS 재인입 때 고칠지"를 팀과 함께 판단해야 했다. 문제를 이해하는 것과 그걸 언제 반영할지 우선순위를 정하는 것은 별개의 의사결정이라는 것도 이번에 배운 부분이다.
부록: 예상 질문 정리 (인터뷰 대비용 메모)
Q. 왜 바로 코드를 고치지 않고 로그부터 넣었나요? 원인 후보가 다수였고 재현이 안 되는 상황이었다. 추측으로 수정하면 고쳐졌는지 검증할 수단이 없다. 관측 가능성 확보가 선행되어야 수정의 효과를 측정할 수 있다고 판단했고, 실제로 로그 배포 후 확보한 데이터를 근거로 원인을 완전히 확정할 수 있었다.
Q. 재현이 안 되는 오류는 어떻게 테스트했나요? 운영 코드를 건드리지 않는다는 제약 하에 실패 유형별로 재현 수단을 나눴다. 서버 예외는 잘못된 파라미터로 유도했고, HTTP 오류는 Requestly로 응답을 Mock했다(DevTools 요청 차단은 status=0만 만들어서 부적합했다). 브라우저 API 실패는 DevTools Snippets에서 FileReader/XMLHttpRequest를 일시적으로 가로채서 재현했고, 프록시 오염 문제는 iframe에서 네이티브 구현체를 꺼내 우회했다. 인프라 장애(Redis)는 재현이 불가능하다고 판단해 테스트 코드로 대체했다.
Q. 로그 설계에서 신경 쓴 점은? 상관관계(requestId + captchaId로 서버·클라이언트 로그 연결), 검색성([CAPTCHA] 접두어 + phase= 키 통일), 보안(토큰·개인정보·CAPTCHA 정답 미기록, 서버 저장 시 마스킹), 비용(성공 로그는 2차 배포에서 제거) 네 가지를 같이 고려했다.
Q. 이 이슈는 완전히 해결됐나요? 솔직히 말하면 단계적으로 진행 중이다. Phase 1(진단 체계 구축)은 완료됐고 실제로 운영 로그에서 실패 사례를 확보했다. Phase 2에서는 근본 원인(하드코딩된 정적 더미 이미지)을 완전히 확정했고, 새로고침·재부팅으로도 회복되지 않는 이유까지 코드 근거로 설명할 수 있게 됐다. 최소 변경 대응안까지 마련했지만, 실제 코드 반영은 발생 빈도와 회귀 위험을 고려해 CS가 재인입되는 시점에 진행하기로 팀 차원에서 결정했다. 로그가 없었다면 계속 "iOS 단말 이슈"로 남아있었을 문제를 구조적 결함으로 규명한 것이 Phase 1과 2를 거치며 얻은 가장 큰 성과라고 생각한다.
TL;DR — VM 2대가 동시에 재부팅된 후 WildFly 도메인 컨트롤러가 자동 기동되지 않았다. 증상은 슬레이브 서버의 반복 종료였지만, 근본 원인은 systemd unit 파일의 WantedBy를 wantedBy로 쓴 오타 한 글자였다. 원인 추적부터 복구까지 약 40분. 이 글은 그 40분의 기록과, 거기서 건진 교훈에 대한 이야기다.
배경: WildFly Domain Mode
담당하는 인증 서비스의 개발 환경은 WildFly를 도메인 모드로 운영한다. 서버는 두 대다.
도메인 컨트롤러(마스터, 10.0.0.10) — 원본 WAR 배포본과 서버 그룹 설정을 보관하고, 슬레이브에 설정을 배포한다. 관리 포트는 9990.
호스트 컨트롤러(슬레이브, 10.0.0.11) — 마스터로부터 설정과 WAR를 받아 실제 서비스 JVM 인스턴스를 기동한다. 실제 코드가 돌아가는 서버다.
여러 모듈의 JVM 인스턴스를 서버 그룹 단위로 묶어 관리할 수 있다는 게 도메인 모드의 장점이지만, 뒤집어 말하면 마스터가 죽으면 슬레이브는 기동조차 못 하는 구조다. 이 사실이 이번 장애의 복선이 된다.
장애: 표준창이 열리지 않는다
어느 오후, 개발망의 인증 표준창이 HTTP 503을 반환하기 시작했다. 슬레이브 서버에 들어가 보니 이상한 패턴이 보였다. WildFly 프로세스가 기동되고 약 33초 만에 종료되기를 반복하고 있었다. 재시작해도 똑같았다.
먼저 서버에 무슨 일이 있었는지부터 확인했다.
last -x reboot shutdown | head -5
reboot   system boot  3.10.0-1160.el7. Wed ... 15:16
reboot   system boot  3.10.0-1160.el7. (약 4개월 전)
reboot   system boot  3.10.0-1160.el7. (약 9개월 전)
마스터와 슬레이브 두 VM이 같은 시각에 재부팅되어 있었다. 재부팅 이력을 거슬러 올라가 보니 수개월 간격으로 같은 패턴이 반복된 흔적도 있었다. 즉, 이건 오늘 처음 생긴 문제가 아니라 재부팅될 때마다 터질 수 있는 문제가 잠복해 있다가 이번에 드러난 것이었다.
추적: 증상이 있는 곳에 원인이 있는 건 아니다
반복 종료하는 건 슬레이브니까 처음엔 슬레이브 설정을 의심했다. 그런데 로그를 열어보니 이야기가 달랐다.
INFO  [org.jboss.as.host.controller] WFLYHC0148: Connecting to master host controller remote://10.0.0.10:9990
ERROR [org.jboss.as.host.controller] (Controller Boot Thread) WFLYHC0052: Could not connect to master. Aborting.
      Error was: java.net.ConnectException: WFLYPRT0053: Could not connect to remote://10.0.0.10:9990. The connection failed
INFO  [org.jboss.as.process] WFLYPC0009: Process terminated, exit code 99
슬레이브는 자기 잘못으로 죽는 게 아니었다. 마스터에 연결이 안 돼서 30초 동안 11회 재시도한 뒤 스스로 종료(exit code 99)하고 있었다. 아까 관찰한 "33초 만에 종료"는 재시도 30초 + 종료 처리 3초였던 것이다.
systemd는 unit 파일의 키 이름을 대소문자까지 정확히 구분한다. 그리고 모르는 키는 에러를 내는 대신 조용히 무시한다. [Install] 섹션에 유효한 WantedBy가 없으니 systemctl enable을 해도 multi-user.target 아래에 심볼릭 링크가 생기지 않고, 상태는 static으로 표시되며, 부팅 시 자동 시작 대상에서 조용히 빠진다.
무서운 건 이 오타가 평소엔 아무 증상도 만들지 않는다는 점이다. 수동으로 systemctl start를 하면 멀셟하게 잘 뚜다. 재부팅이라는 조건이 충족될 때만 발현되는 잠복 결함이었고, 그래서 수개월 간 아무도 모르고 있었다.
복구: 순서가 전부다
복구 자체는 단순하다. 다만 도메인 모드에서는 기동 순서가 중요하다. 마스터가 없는 채로 슬레이브를 먼저 올리면 33초 뒤 또 죽는다.
마스터 기동 → 관리 포트 9990이 열릴 때까지 대기 (실측 약 20~30초)
슬레이브 기동
서비스 JVM 인스턴스 기동 확인
여기서 한 가지를 덩붙였다. 슬레이브 기동이 성공했는지를 언제 판단할 수 있을까? 연결 실패 시 33초 만에 종료된다는 실측치가 있으니, 여유를 더해 "기동 후 40초가 지나도 active (running)이면 성공"이라는 판정 기준을 런북에 명시했다. "좀 기다려보고 괜찮으면 된 거에요" 같은 감으로는 다음 사람이 복구할 수 없다. 런북의 판정 기준은 숫자여야 한다.
장애 인지부터 서비스 정상화까지 약 40분이 걸렸다.
남은 숙제
오타 수정 — unit 파일 수정 권한이 운영 주체와 분리되어 있어 담당 부서에 수정을 요청한 상태다. 수정 전까지는 재부팅 시 동일 장애가 재발한다. 그래서 런북이 더 중요해졌다.
VM 2대 동시 재부팅의 원인 — 수개월 간격으로 반복된 패턴이라 하이퍼바이저나 전원 이벤트 쪽을 의심하고 있지만 아직 확인되지 않았다.
헬스체크 알림 — 이번에는 사용자가 503을 보고 나서야 인지했다. 관리 포트 헬스체크 기반 알림을 붙이면 재부팅 직후 미기동을 먼저 탐지할 수 있다.
배운 것
증상이 보이는 서버가 범인이 아닐 수 있다. 반복 종료는 슬레이브에서 일어났지만 원인은 마스터에 있었다. 분산 구조에서는 "이 서버가 의존하는 것"까지 의심 범위에 넣어야 한다.
조용히 실패하는 설정이 제일 무석다. systemd는 모르는 키를 에러 없이 무시한다. 설정이 "적용된 것 같은 상태"와 "실제 적용된 상태"는 다르다. systemctl is-enabled 같은 명령으로 적용 상태를 검증하는 습관이 필요하다.
재부팅은 가장 싸고 확실한 카오스 테스트다. 재부팅 후 서비스가 스스로 돌아오는지는 평소엔 절대 검증되지 않는 경로다. 이번 잠복 결함은 그 경로에 수개월간 숨어 있었다.